Skip to content

CosmoEdge / 预装设备

算法已预装,接入视频做分析。

随附安全帽、烟火、跌倒、人车等分析模型和场景模板,已完成对应平台适配。接入视频,设置检测区域和告警规则,即可开展现场分析。
21–27个预置模型包,按平台提供
29类可配置场景模板
查看多路任务与 72 小时运行实测 已有硬件?从开源自部署开始
Sophon BM1688
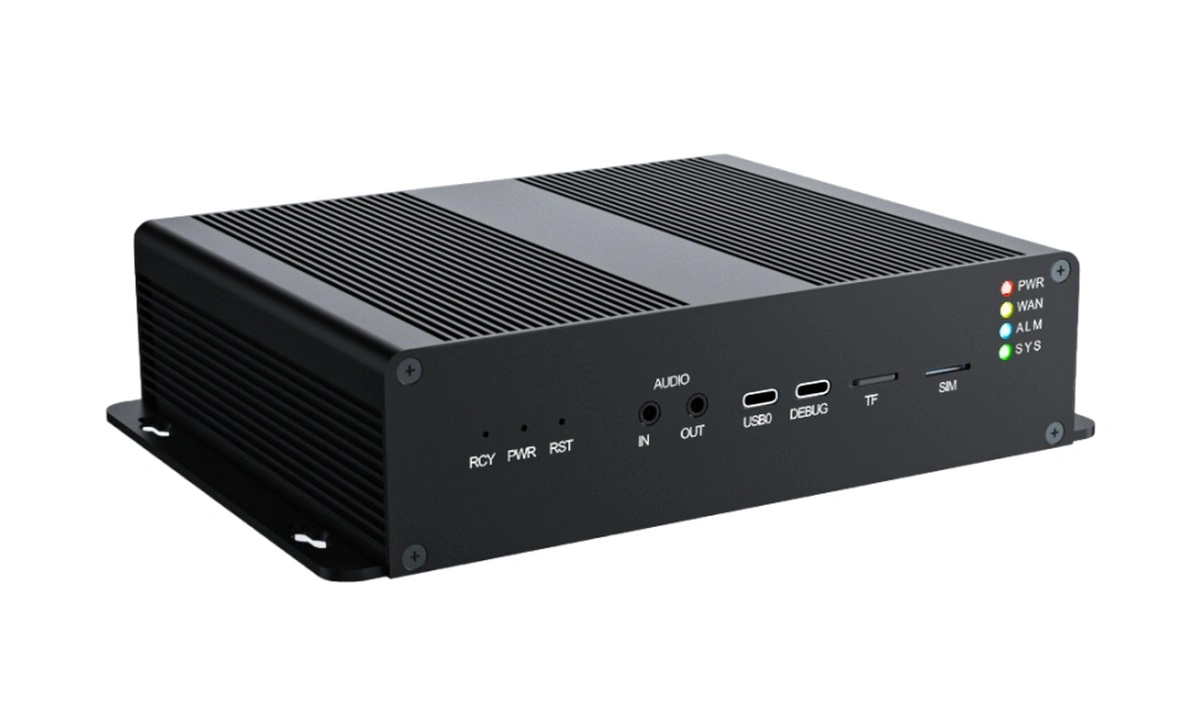
CosmoEdge BM1688 设备正面实物展示
BM1688 型号实物图,具体接口以商品配置为准。8 GB · 64 GB eMMC
安全帽烟火检测人员跌倒人车分析

算法、运行环境与场景模板随设备交付。按现场需求调整区域、阈值与事件规则。

配置比较

比较模型平台、内存与算力。

三款配置均含 64 GB eMMC 存储。结合已有模型格式、内存需求与任务条件,选择起步设备。

01

Rockchip

RK3576

Rockchip RKNN 平台

覆盖人员、人车与安全行为分析;适合从已提供的 RKNN 模型与场景开始。

NPU 标称算力
6 TOPS
内存
4 GB LPDDR5
存储
64 GB eMMC
预置模型包
21 个
02

Sophon

CV186AH

Sophon 平台 · 8 GB 内存

采用 CV186X 平台资源,包含文本提示目标检测与图像分割模型。

NPU 标称算力
7.2 TOPS
内存
8 GB LPDDR4X
存储
64 GB eMMC
预置模型包
26 个
03

Sophon

BM1688

Sophon 平台 · 16 TOPS

27 个预置模型包;可结合公开混合任务报告评估多任务部署。

NPU 标称算力
16 TOPS
内存
8 GB LPDDR4X
存储
64 GB eMMC
预置模型包
27 个

淘宝店铺:御宇智能智算设备店 · 价格更新于 2026-09-07,实际成交价以商品页面为准。

TOPS 为硬件标称算力。任务路数与处理速度取决于模型、输入频率和运行配置。CV186AH 对应下方 CV186X 平台资源。

性能实测

人员与安全帽分析的实测表现。

人员检测 + 未佩戴安全帽分析:每路运行两个任务、三个模型阶段,每任务目标 5 FPS。以下为公开报告中的测试平台结果。

测试平台混合任务通过路数72 小时固定配置模型资源差异
RK3576≥ 88 路 · 16 个任务人员、人车、安全行为、视觉语言
CV186X≥ 88 路 · 16 个任务另含文本提示检测、图像分割
BM1688≥ 168 路 · 16 个任务另含文本提示检测、图像分割

交付内容

设备、软件和随附资源。

01

设备与运行环境

所选设备预装 CosmoEdge,并配置对应芯片的 NPU 加速环境。

02

模型与场景预设

按平台提供模型包与 29 类可配置场景模板;绑定输入源,再按现场调整区域、阈值与事件规则。

03

部署与项目沟通

提供部署支持。自有模型适配、业务系统对接及现场服务的具体范围,在项目沟通时确认。

随附模型与模板、服务范围以所选商品和交付约定为准。模型接入、现场规则与系统对接需求可在购买前沟通。

预置资源 / 2026-09-08

查看各平台的预置模型与场景模板。

按用途查找模型和模板。运行模板前,需选择对应平台的模型,并接入图片或视频。

BM1688
预置模型 27

人员与车辆分析、安全行为识别、文本提示检测、图像分割、视觉语言分析

数量按预置模型包统计。分类模型通常与检测模型组合使用,特征与关键点模型用于人脸或人体比对流程。

三平台均提供视觉语言研判模型,按设备交付配置启用。

展开其余 21 个模型收起完整模型清单
人脸检测FaceRGBDetection
定位人脸,为比对、口罩、质量分析提供裁剪区域
人脸特征提取FaceRGBRecognition
提取人脸特征,用于人脸库检索和比对
口罩识别FaceMask
识别戴口罩、未戴口罩
人脸质量评估FaceQuality
评估人脸朝向、完整度与清晰度
人脸关键点FaceLandmark
定位人脸关键点,供对齐和特征提取使用
头肩检测HsDetection
定位人体头肩区域
人体属性识别PedestrianAttribute
识别衣着、颜色等人体属性
人体特征提取PedestrianRecognition
提取人体特征,用于人体或工服比对
人体质量评估PedestrianQuality
评估人体图像质量,筛选适合比对的目标
睡岗识别PedSleep
识别趴睡、卧睡
车辆属性识别VehicleAttribute
识别车型、颜色、车身朝向等属性
电动车分类ElectricElevatorClassify
区分自行车和电动车,支持电动车管理场景编排
垃圾堆检测RubbishDumpDetection
定位垃圾堆积区域
人体安全帽分类PedHelemet
基于人体区域识别安全帽、头盔、普通帽和未戴帽
跌倒识别PedFalldown
对人体目标进行跌倒分类
YOLOv8目标检测Yolov8Detect
通用目标检测,可用于图片和视频目标分析
YOLOv12目标检测Yolov12
通用目标检测,可用于图片和视频目标分析
鼠类检测MouseDetection
定位鼠类目标
YOLO26目标检测Yolo26
目标检测,可用于图片目标分析
文本提示目标检测GrounddingDIno
按文本提示定位目标,Grounding DINO模型
图像分割SAM2
对目标区域生成分割掩码,SAM2模型

三平台共用的场景模板 29

选择图片或视频输入源,绑定模型,再设置区域、规则线、时间和告警条件。

  • 01
    区域入侵区域入侵告警
  • 02
    区域人数统计区域实时人数统计
  • 03
    未戴安全帽未戴安全帽告警
  • 04
    检测后分类算法先定位目标,再对目标进行分类
查看全部 29 类场景模板与用途收起场景模板清单
人脸比对
人脸1:N比对
区域入侵
区域入侵告警
人员聚集
区域人数超限告警
人员跌倒
人员跌倒告警
车辆违停
车辆停留超时告警
烟雾检测
烟雾持续告警
火焰检测
火焰持续告警
吸烟检测
吸烟告警
打电话检测
打电话告警
人流量统计
过线进出人数统计
未戴安全帽
未戴安全帽告警
离岗检测
区域人数不足超时告警
玩手机检测
玩手机告警
车牌识别
车牌定位与文字识别,需配套车牌识别模型
未穿反光衣
反光衣穿戴比对
区域人数统计
区域实时人数统计
绊线检测
单向或双向越线告警
未穿工服
工服库比对告警
睡岗检测
趴睡、卧睡告警
检测大模型
根据文本提示定位目标
人脸识别算法
对图片执行人脸检测、特征提取与识别
视觉检测大模型分析
对视频执行文本提示目标检测与事件分析
分割大模型
对图片中的目标生成分割结果
视觉分割大模型分析
对视频中的目标执行分割分析
视觉语言大模型分析
按提示词分析视频画面并形成研判结果
检测类算法
对图片执行目标检测
检测后分类算法
先定位目标,再对目标进行分类
检测后分割算法
先检测目标,再生成目标分割结果
视觉语言大模型
根据图片和提示词生成分析结果

购买前了解

购买前的常见问题。

已有自己的 YOLO 模型,能否使用?

可以按模型接入流程准备和导入。需要匹配目标平台的模型格式、输入输出和解析配置;训练权重需要先完成导出与平台适配。

查看模型接入教程 →
购买后怎样验证现成场景?

从随附模型和场景预设开始,先用测试素材跑通流程,再用现场视频调整区域、阈值和规则,确认实际效果。

查看首次检测步骤 →
不买设备能否使用软件?

可以。CosmoEdge 引擎代码采用 Apache-2.0 许可,提供自部署路径。模型资产的来源和许可单独说明。

了解模型来源与许可 →
多路视频和低频抓拍应如何选型?

结合模型、每路任务、输入频率和时延要求选型。提供你已掌握的条件,即可据此讨论配置和验证方式。

咨询设备选型 →

下一步

告诉我们任务需求,帮你确定设备配置。

引擎代码采用 Apache-2.0 许可证。模型与依赖遵循各自许可。

CosmoEdge / 项目咨询

聊聊你的边缘 AI 项目。

模型部署、设备选型或系统对接,都可以从你眼前的问题开始。

商务与项目咨询

hello@cosmowander.ai

安装使用与开源问题前往社区讨论
邮件中可以介绍哪些信息?

先介绍已掌握的部分,其余信息可以在沟通中补充。

  • 应用场景

    想识别什么,事件如何使用

  • 已有条件

    已有的模型、设备或系统

  • 处理需求

    视频路数、频率与时延要求

  • 项目进展

    项目阶段,以及眼前的问题