VLM 与 DINO:提示词驱动的视觉任务
| 项目 | 说明 |
|---|---|
| 适合谁 | 需要验证长尾视觉需求的方案工程师、算法工程师和高级用户 |
| 完成后能做什么 | 用 VLM 创建状态判断任务,用 DINO 创建开放类别检测任务,并用正负样本评估结果 |
| 使用前提 | 已会配置通道、区域、参数和运行策略;运行环境已安装对应模型,或已有兼容的远程 VLM 服务 |
| 预计时间 | 45–70 分钟 |
| 是否需要设备 | 本地 Qwen VLM 需要 Sophon 后端及匹配模型;DINO 需要与当前后端匹配的模型;远程 VLM 还需要网络与服务凭据 |
| 最终验收结果 | VLM 对固定正负样本给出可复测判断,DINO 在目标位置输出检测框,视频与事件记录符合任务定义 |
本页从一个任务问题开始:如何用提示词定义一个可验证的视觉规则?
例如:
- 楼道中是否有垃圾?
- 消防柜门是否关闭?
- 垃圾桶是否满溢?
- 施工围挡是否倾倒?
- 城墙表面是否有明显人为破坏?
这些需求通常难以直接对应一个固定类别模型。VLM 和 DINO 可以用于低成本可行性验证,但“无需训练即可试验”不等于“无需样本即可上线”:仍要定义边界、准备正负样本并记录误报、漏报、时延和资源占用。
1. 先选择正确的能力
| 能力 | 最适合回答 | 输出 | 典型用途 | 主要限制 |
|---|---|---|---|---|
| 传统检测/分类模型 | 已知固定类别是否出现 | 检测框、类别、分数 | 人员、安全帽、车辆等高频任务 | 新类别通常需要模型和数据适配 |
| VLM | 画面是否符合一段语义描述 | 是/否判断与事件 | 门是否关闭、区域是否整洁、是否存在疑似破坏 | 受提示词、画质、采样和模型随机性影响;本地 Qwen 当前依赖 Sophon |
| DINO | 某个开放类别在哪里 | 检测框、类别、分数 | 灭火器、垃圾、包裹等开放类别定位 | 目标必须肉眼可辨;小目标、密集目标和抽象概念仍需实测 |
简单记忆:
- 想判断“是不是某种可见状态”:先验证 VLM。
- 想定位“某类目标在哪里”:先验证 DINO。
- 要稳定地实时检测固定类别,且已有合适模型:优先传统模型。
适合先用 VLM 或 DINO 验证的需求:
- 低频状态巡检;
- 难以穷举形态的长尾目标;
- 先用图片快速判断需求是否可行;
- 业务方能够对正负样本形成一致标准。
不应只靠一句提示词直接上线的需求:
- 精确计数、细粒度身份或连续动作识别;
- 极小、严重遮挡或肉眼也难分辨的目标;
- 需要确定性低时延或大规模并发,但尚未做目标硬件压测;
- 安全关键自动闭环,没有人工复核或失效保护;
- 业务方自己也无法一致判断哪些样本应该触发。
模板出现在页面上不代表模型文件已经安装。创建任务前先在 模型仓库 确认对应模型可用,确认设备内存、加速器内存和网络满足要求。不要沿用旧版文档中的固定“每帧几秒”“固定并发路数”等数值;这些结果取决于模型、分辨率、取帧频率、后端和设备,应在目标环境测量。
2. VLM:创建状态判断任务
VLM 将画面或 ROI 与提示词一起输入模型,再把“是/否”结果交给事件上报。它通常不产生目标检测框,因此验收重点是回答、抓拍图和事件,不是 OSD 框。
2.1 理解节点流程
以“河道漂浮物识别”为例,打开 任务配置 → 场景任务 → 河道漂浮物识别 → 算法编排。
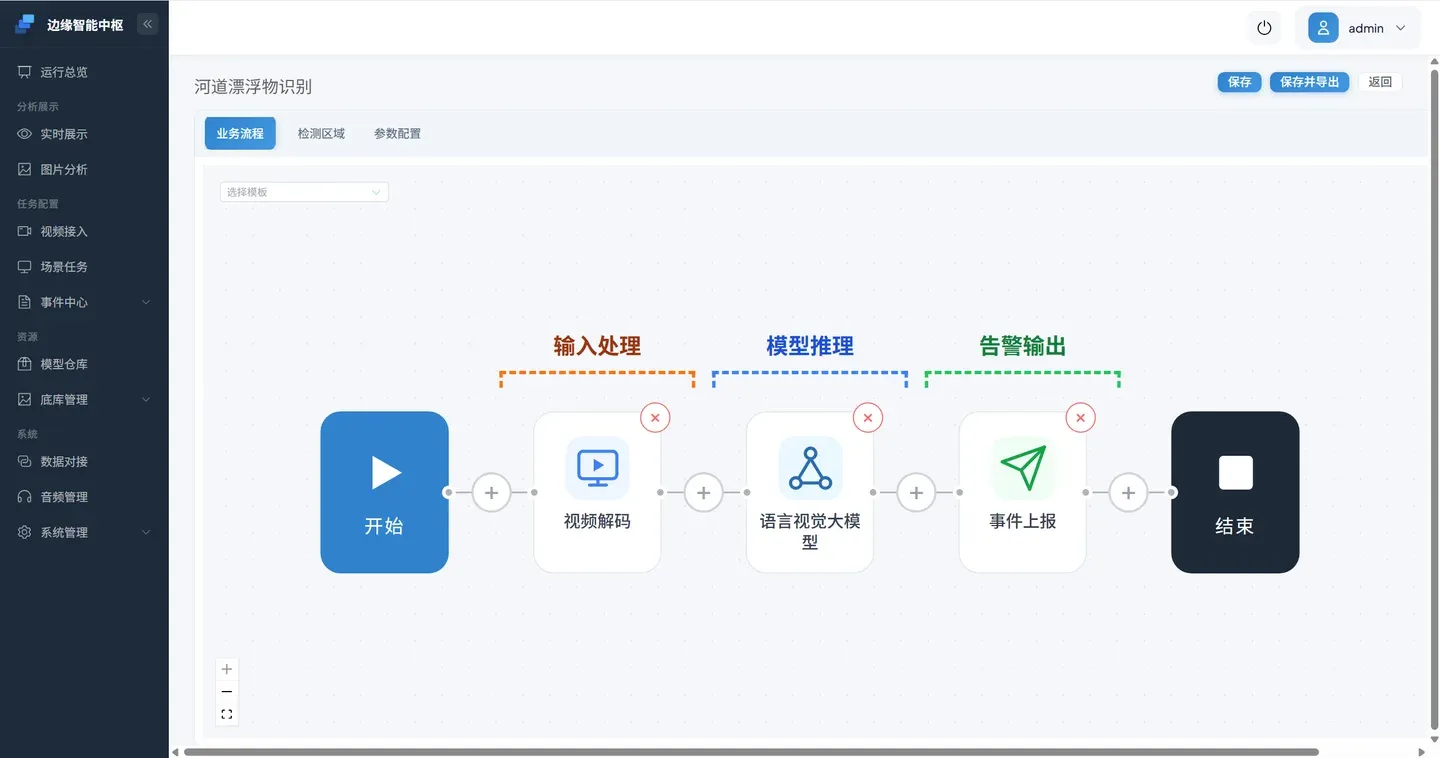
一个视频 VLM 任务通常包含:
- 视频解码:取得视频帧;业务目标必须在图像中肉眼可见。
- 数据预处理:按取帧频率选择帧,并按配置裁剪 ROI。
- 语言视觉大模型:把图像和提示词提交给本地或远程模型。
- 事件上报:把命中结果、抓拍图和时间保存到系统。
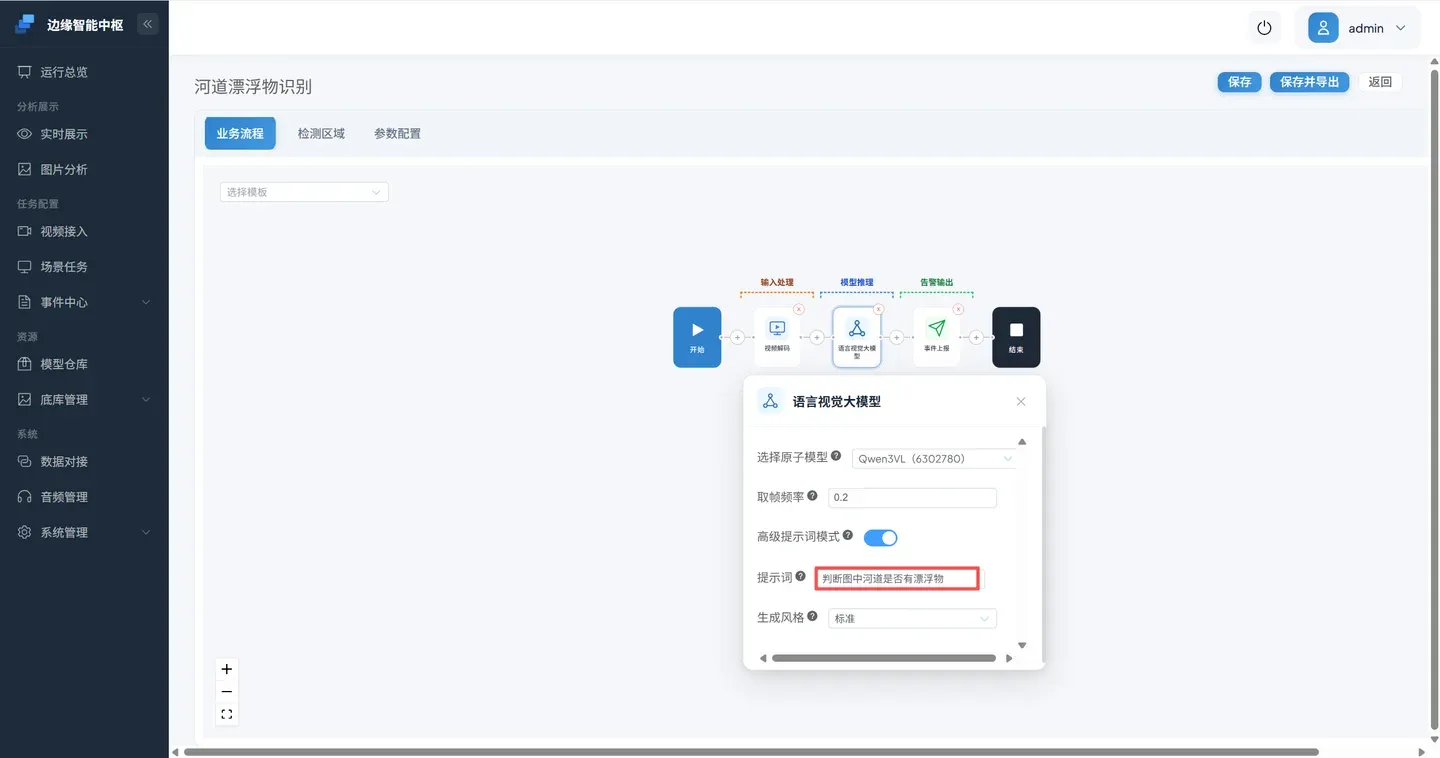
点击 语言视觉大模型 节点打开配置面板。
2.2 正确使用普通与高级提示词模式
完整句子必须开启高级提示词模式
高级提示词模式默认关闭。关闭时,系统会把输入自动包装成“判断图片中是否存在【输入内容】目标,回答是或者否……”。因此关闭模式时只能输入目标短语,例如 河面漂浮垃圾。
要输入包含条件和排除项的完整问题,必须开启 高级提示词模式。系统会保留完整前半段,只追加“回答是或者否”的输出约束。把完整句子填入关闭状态会形成重复、语义错误的提示词。
两种正确写法:
| 模式 | 提示词输入 | 系统实际用途 |
|---|---|---|
| 普通模式(关闭高级模式) | 河面漂浮垃圾 | 快速判断图片中是否存在该目标 |
| 高级模式(开启) | 判断河面区域是否存在塑料袋、瓶子、成片树叶或其他明显漂浮杂物,忽略水面反光和细小波纹 | 使用完整业务条件与排除项进行是/否判断 |
一个可操作的高级提示词包含:
- 观察对象:河面、消防柜、作业区等。
- 可见条件:漂浮物、柜门打开、人员倒地等。
- 排除项:水面反光、阴影、正常风化等。
- 单一结论:能够回答“是”或“否”。
河道示例的期望:
| 输入 | 预期结果 |
|---|---|
| 河面上有清晰可见的塑料瓶、垃圾袋或成片杂物 | 是,并满足事件规则 |
| 只有水波、倒影或零散不可辨识小点 | 否,不产生该类事件 |
2.3 选择本地或远程推理
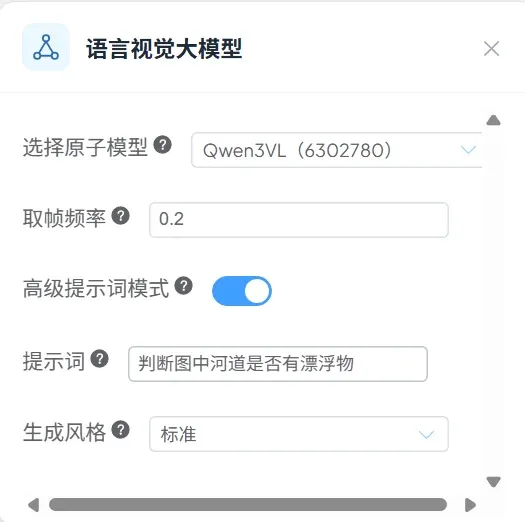
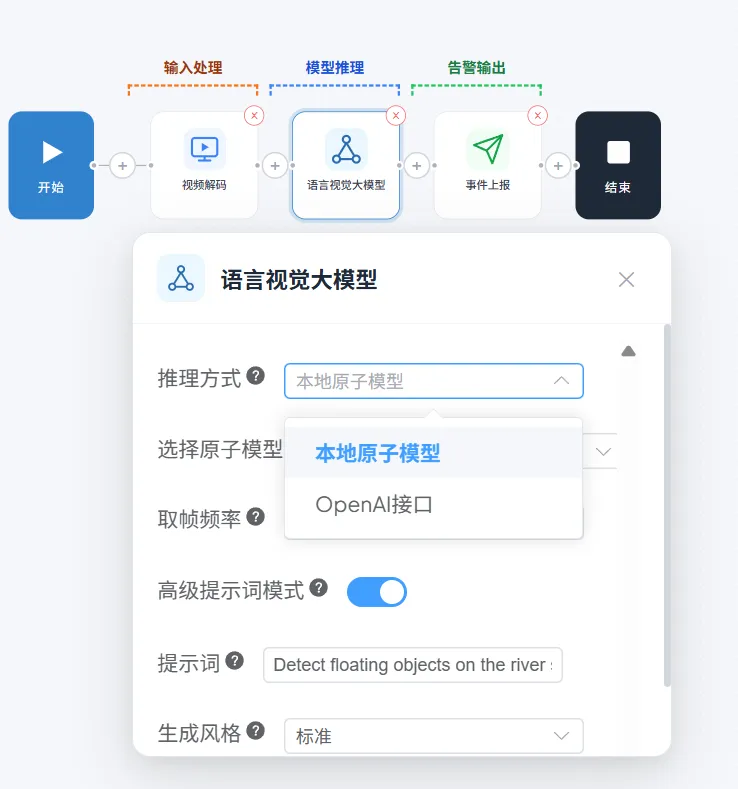
当前 语言视觉大模型 节点包含:推理模式、原子模型或 OpenAI 兼容配置、取帧频率、高级提示词模式、提示词和生成风格。
本地原子模型
选择 本地原子模型,再选择已经导入的 Qwen3VL 原子模型。当前本地实现依赖 Sophon 后端和匹配的模型、分词器资源。模型体积较大,首次初始化可能比后续推理慢;实际时间以目标设备日志和测量为准。
OpenAI 兼容 API
选择 OpenAI API 后填写兼容服务配置。
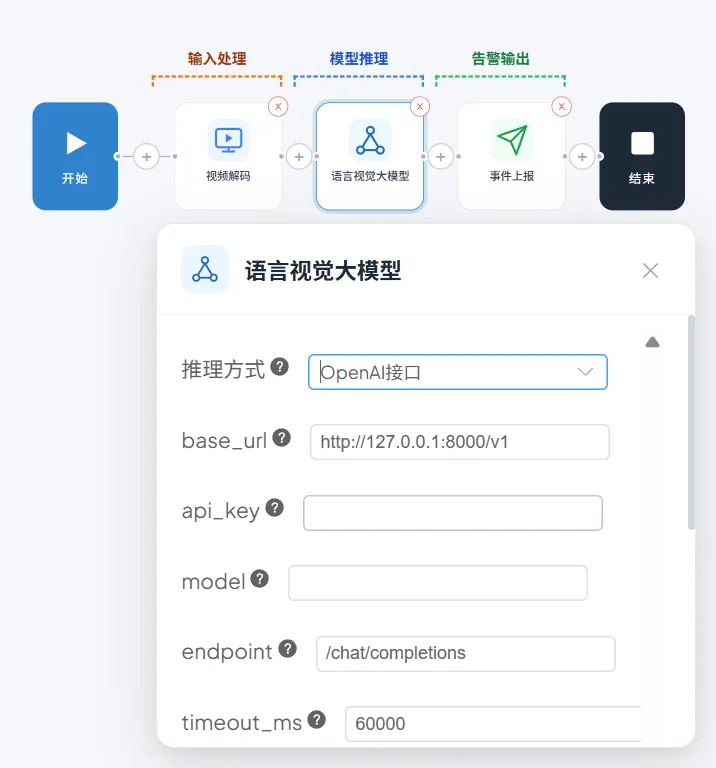
| 页面字段 | 当前配置键 | 说明 |
|---|---|---|
base_url | openai.base_url | 服务根地址,例如自建服务的 /v1 地址 |
api_key | openai.api_key | 服务凭据;仅在本地服务明确关闭鉴权时留空 |
model | openai.model | 远程服务实际暴露的模型名 |
endpoint | openai.endpoint | 默认 /chat/completions |
timeout_ms | openai.timeout_ms | 请求超时,当前页面默认 60000 |
max_tokens | openai.max_tokens | 最大输出 token 数,当前页面默认 256 |
不要把真实密钥写入教程、截图、Pipeline 导出文件或版本库。远程模式还要评估网络稳定性、调用费用、图像数据出域合规性、服务端日志保留和失败重试。接口能返回一次结果不等于视频任务已验收。
取帧频率与生成风格
- 取帧频率单位为 fps,当前节点默认
1,范围由页面约束为0.01–1000,且不应高于上游帧率。0.1表示约每 10 秒取一帧。先按业务允许的发现延迟使用低频,再基于资源测量调整。 - 严谨 / 标准 / 发散控制生成随机性。需要稳定的二元判断时优先比较“严谨”和“标准”。
- 自定义会显示
do_sample、top_k、top_p、temperature。一次只改一项,并把值写入验证记录。
2.4 把河道任务绑定到视频
使用项目
v1.0-videos标签中的河道素材或经授权的现场样本。打开 视频接入 → 添加,创建离线视频通道,然后进入 场景任务分配。
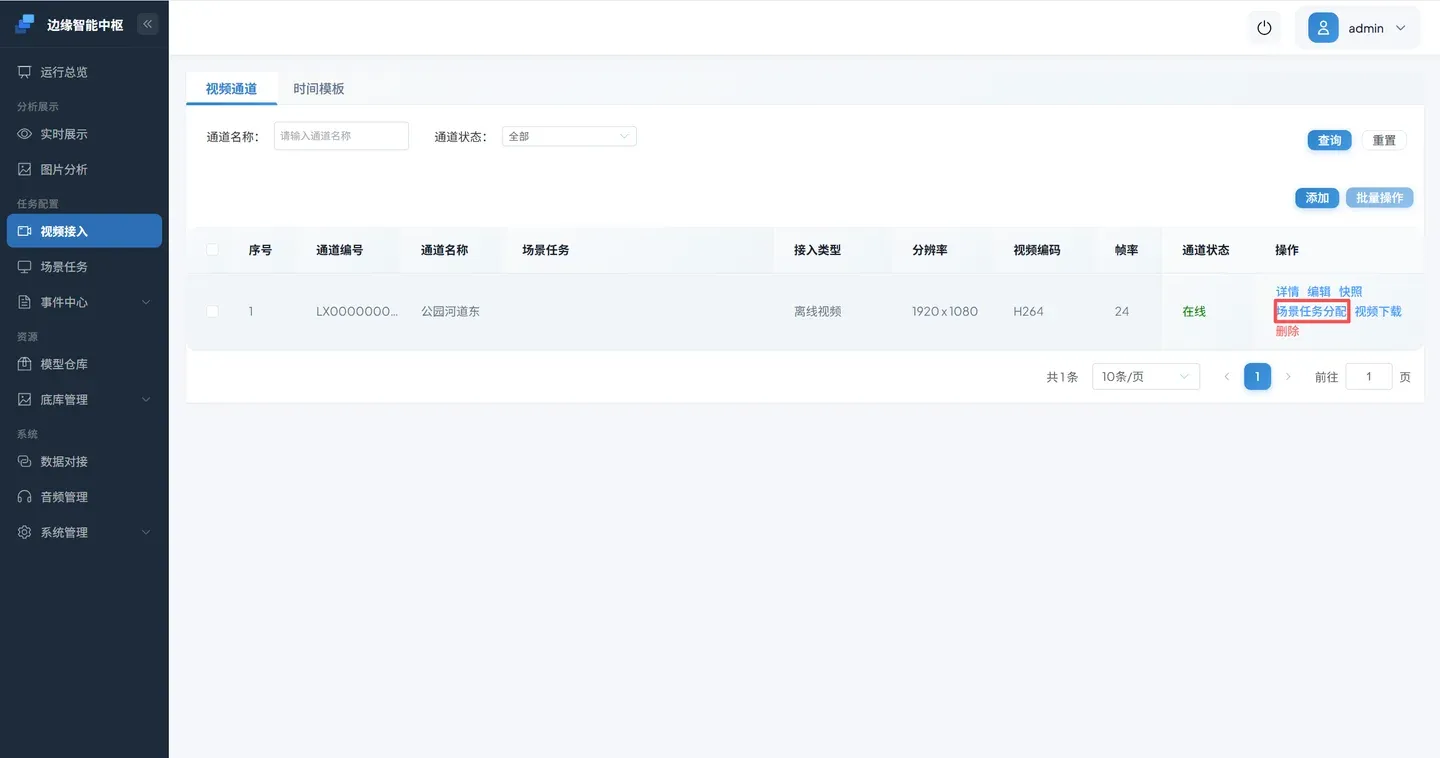
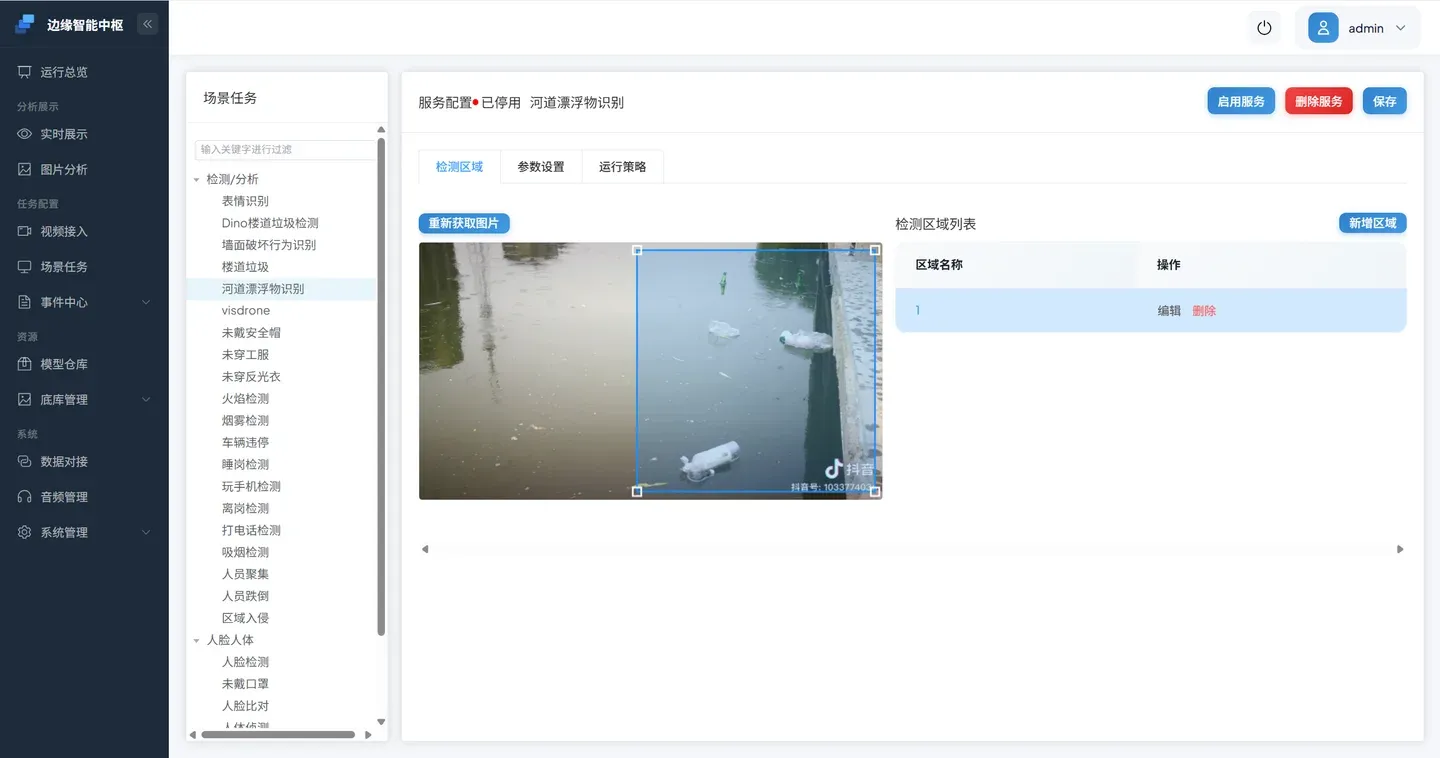
从所有服务中选择 河道漂浮物识别,新增区域。
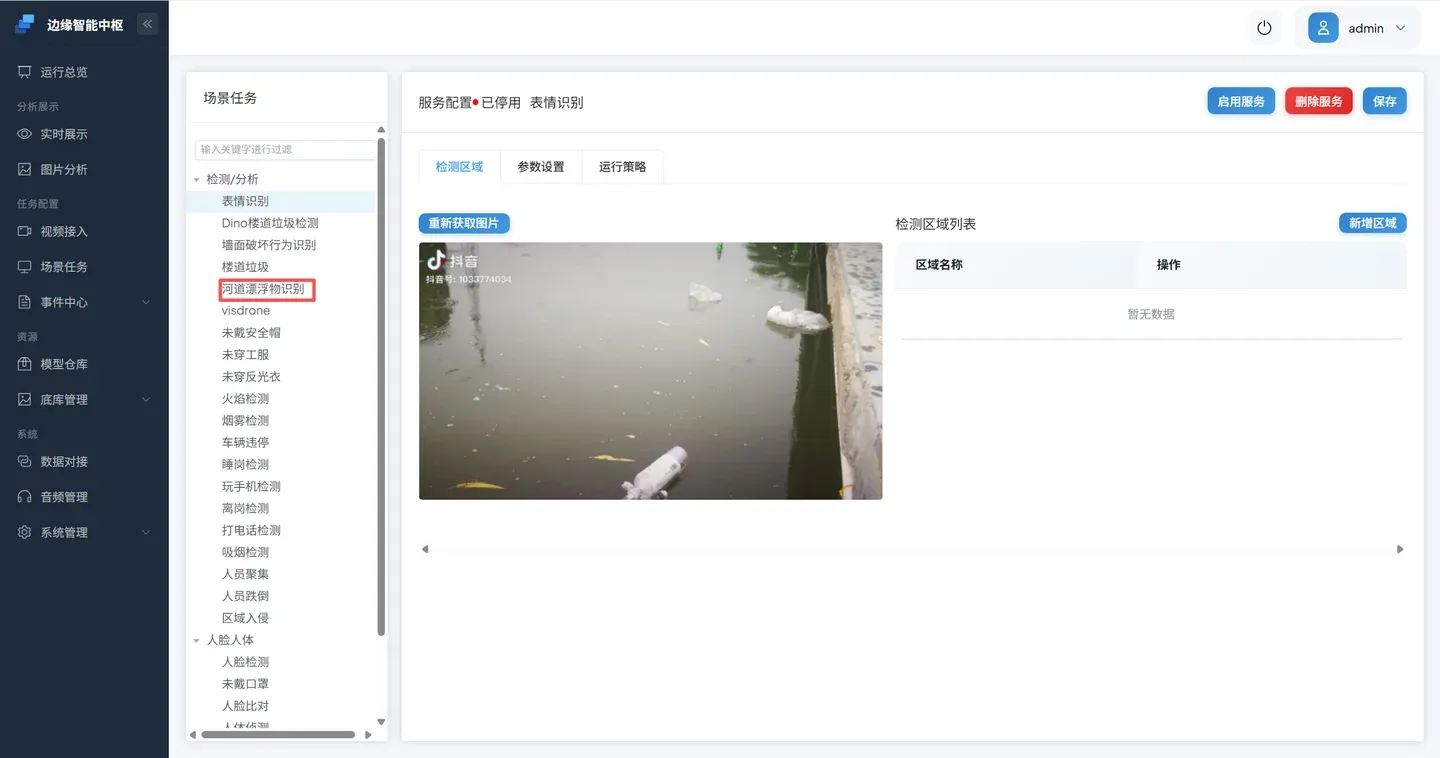
默认区域可以是全屏。为减少河岸、天空和文字水印干扰,收紧 ROI,只覆盖需要判断的水面。
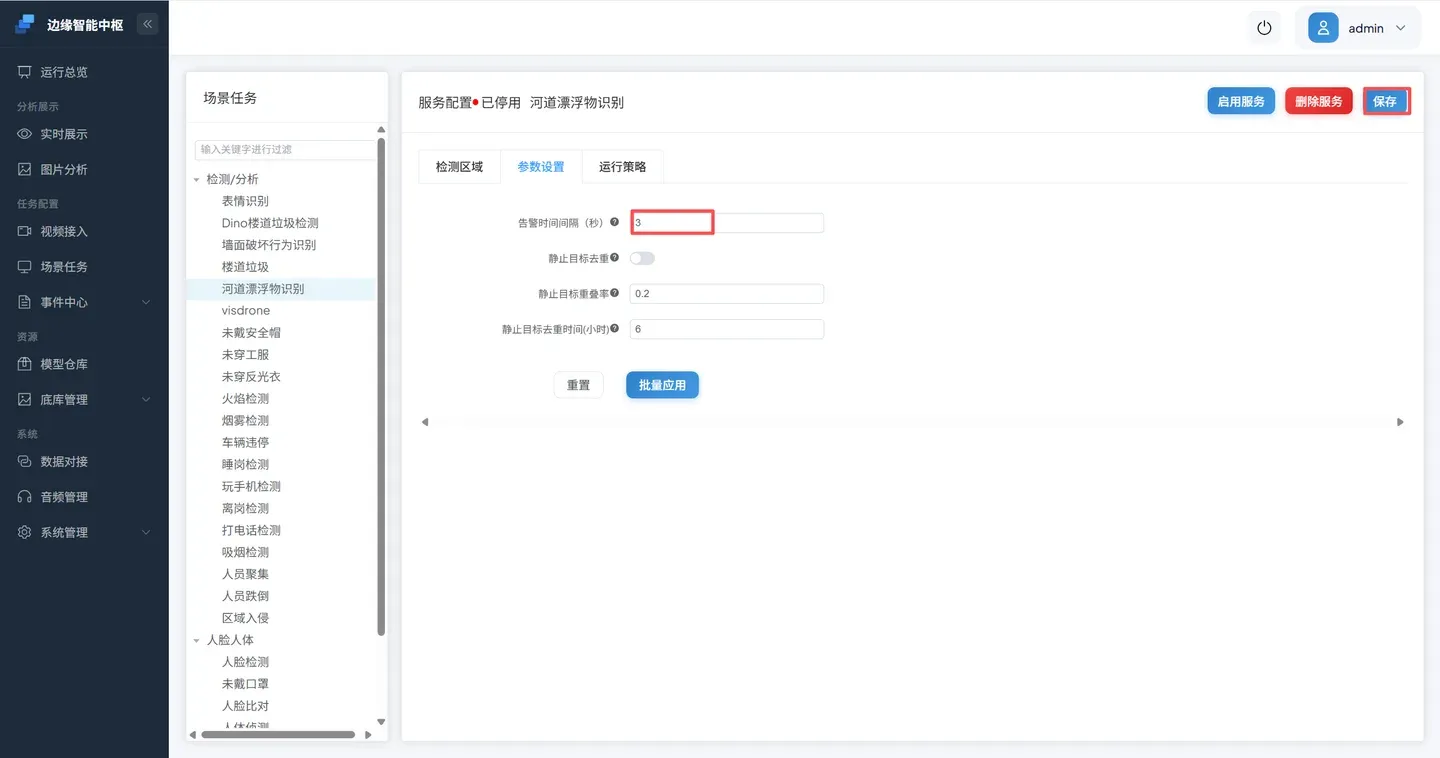
在 参数设置 中配置事件间隔,在 运行策略 中保证当前时段有效,然后保存启动。
2.5 查看实时结果和事件
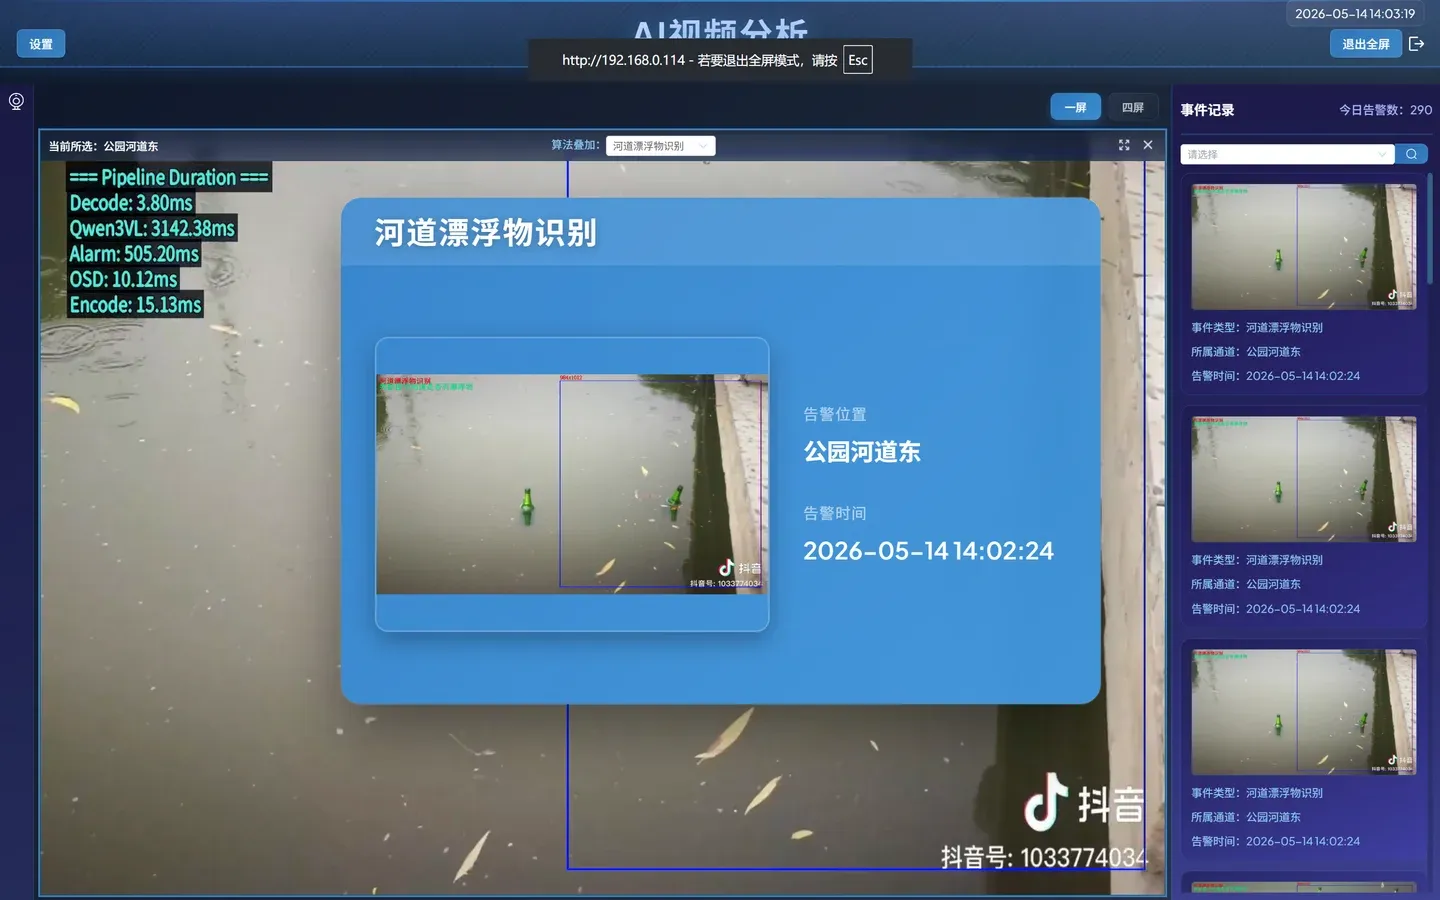
打开 实时展示,选择通道和 河道漂浮物识别 叠加层。
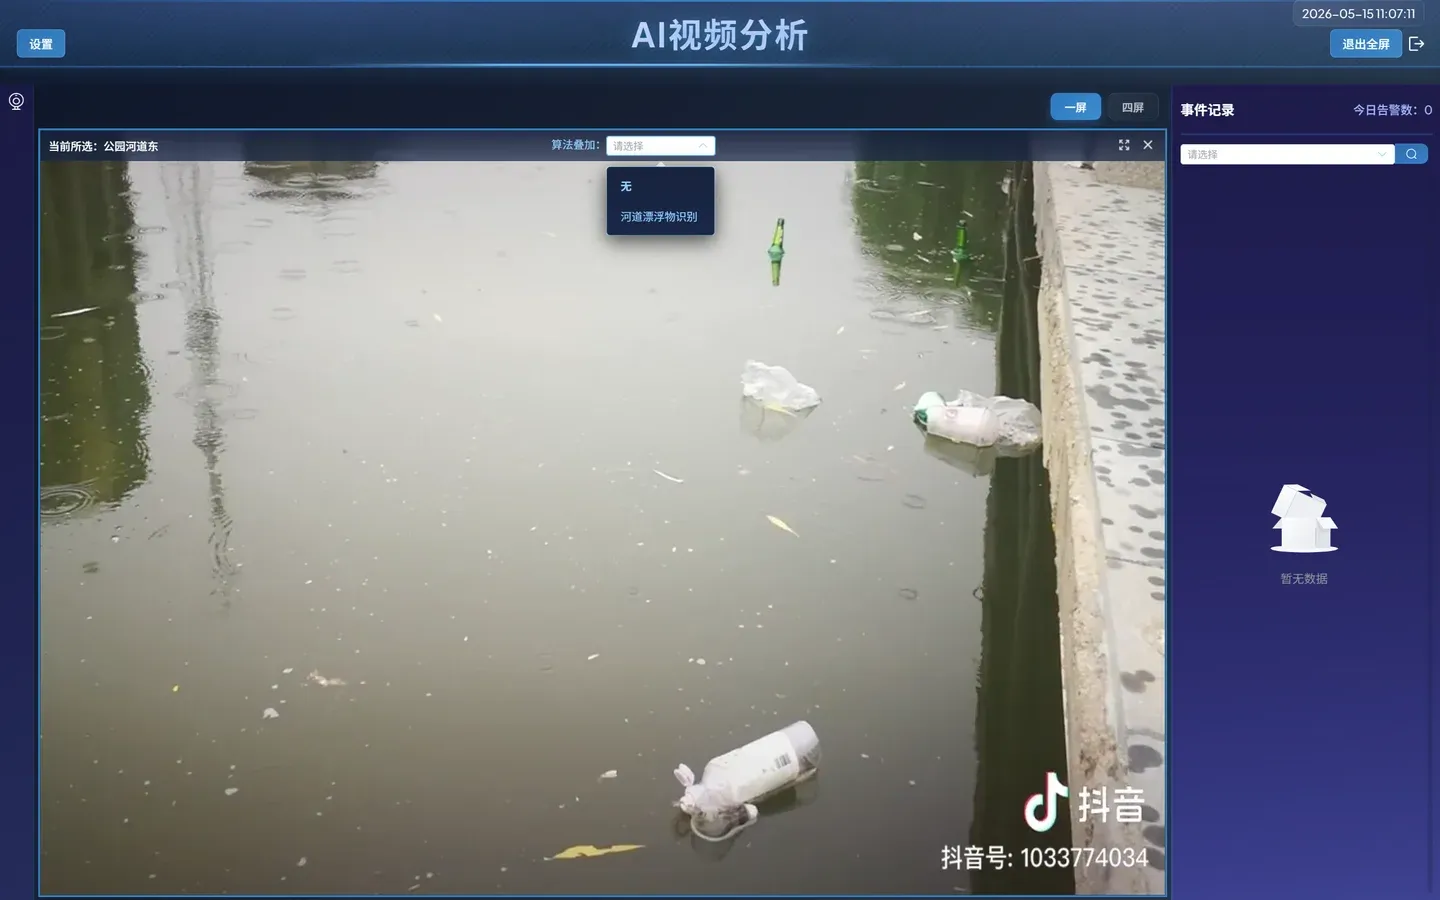
VLM 不画目标框是正常现象。视频应持续播放;当模型回答“是”并满足事件规则时,右侧事件面板显示抓拍和结果。
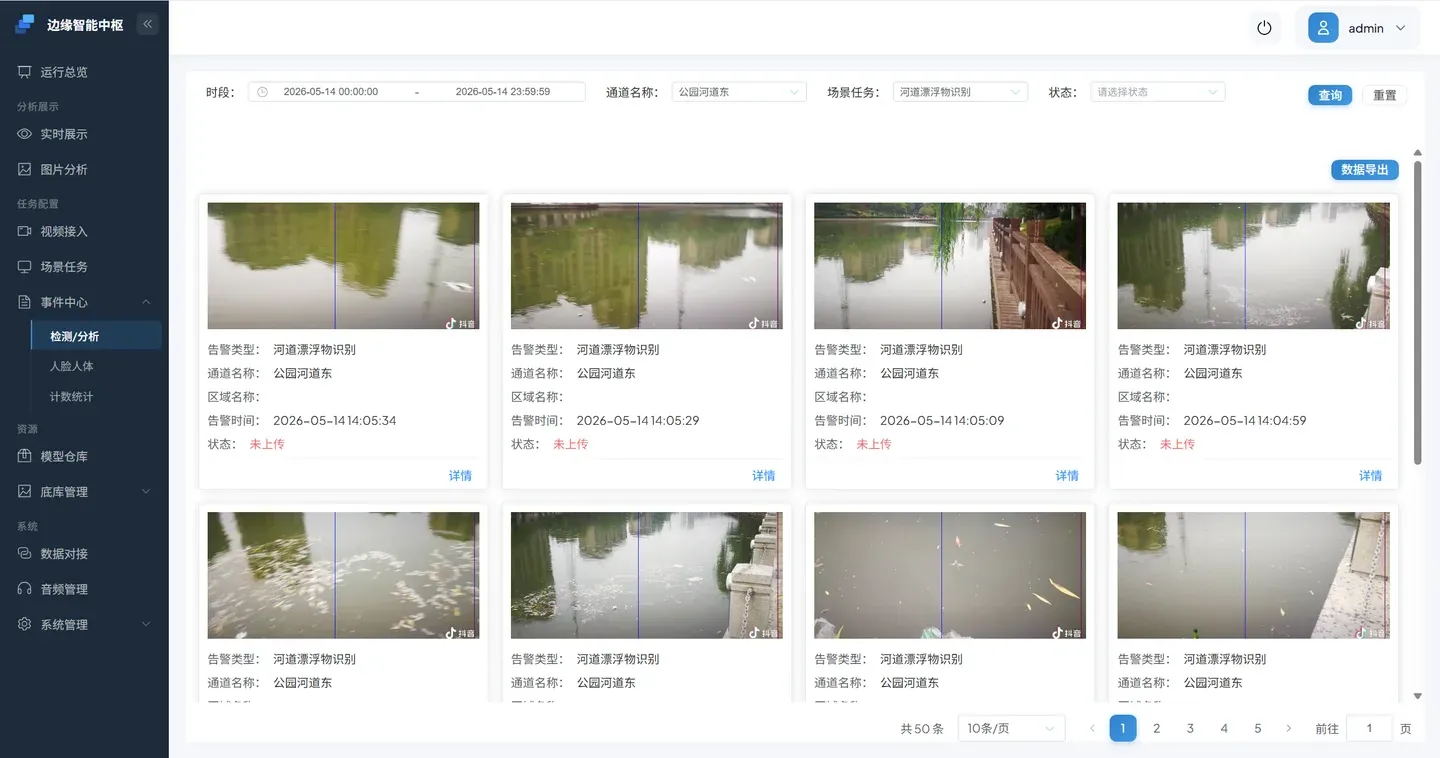
打开 事件中心 → 检测/分析,按通道、任务和时间范围查询。
打开事件详情,核对抓拍图、判断结果和时间戳。
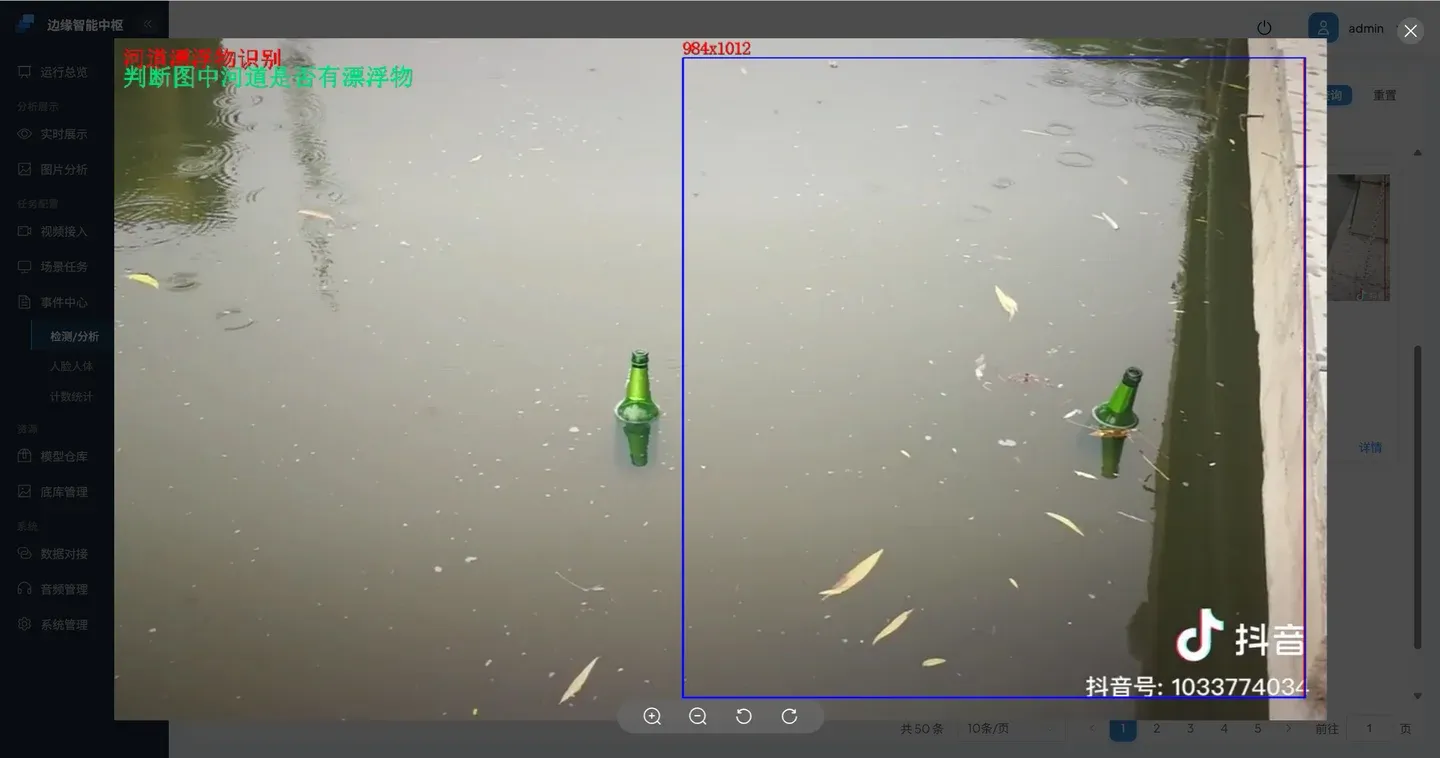
通过标准:正样本片段产生预期判断,负样本片段不产生该类事件,抓拍图来自正确 ROI 和时刻,持续运行时没有反复初始化失败、远程超时或资源不足。
3. 用图片分析验证一个全新 VLM 需求
“城墙破坏检测”用于演示如何先验证需求定义,再接视频。低频事件不适合直接在视频中等待;图片分析可以固定输入,快速比较提示词版本。
3.1 创建图片分析任务
打开 场景任务,点击 新建任务。
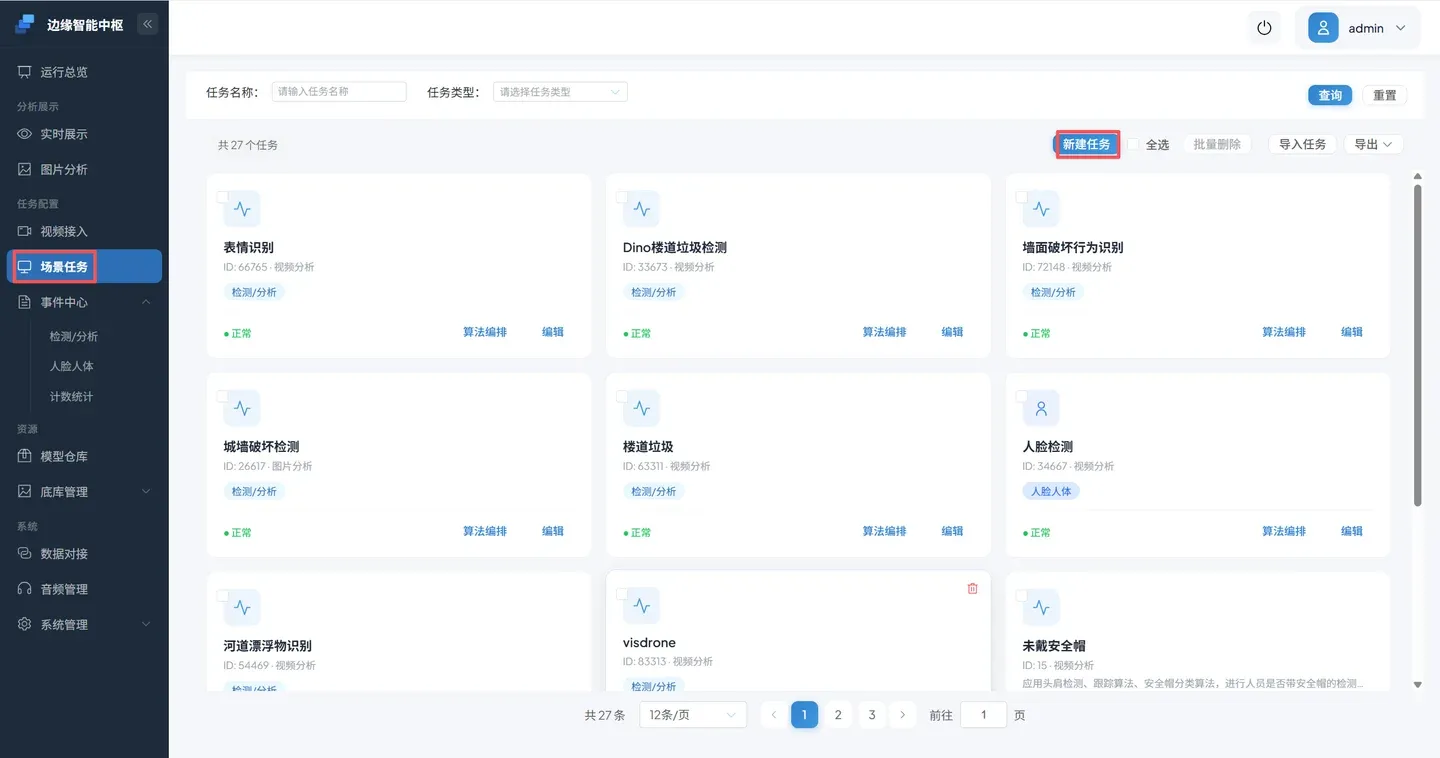
数据源类型选择 图片分析。
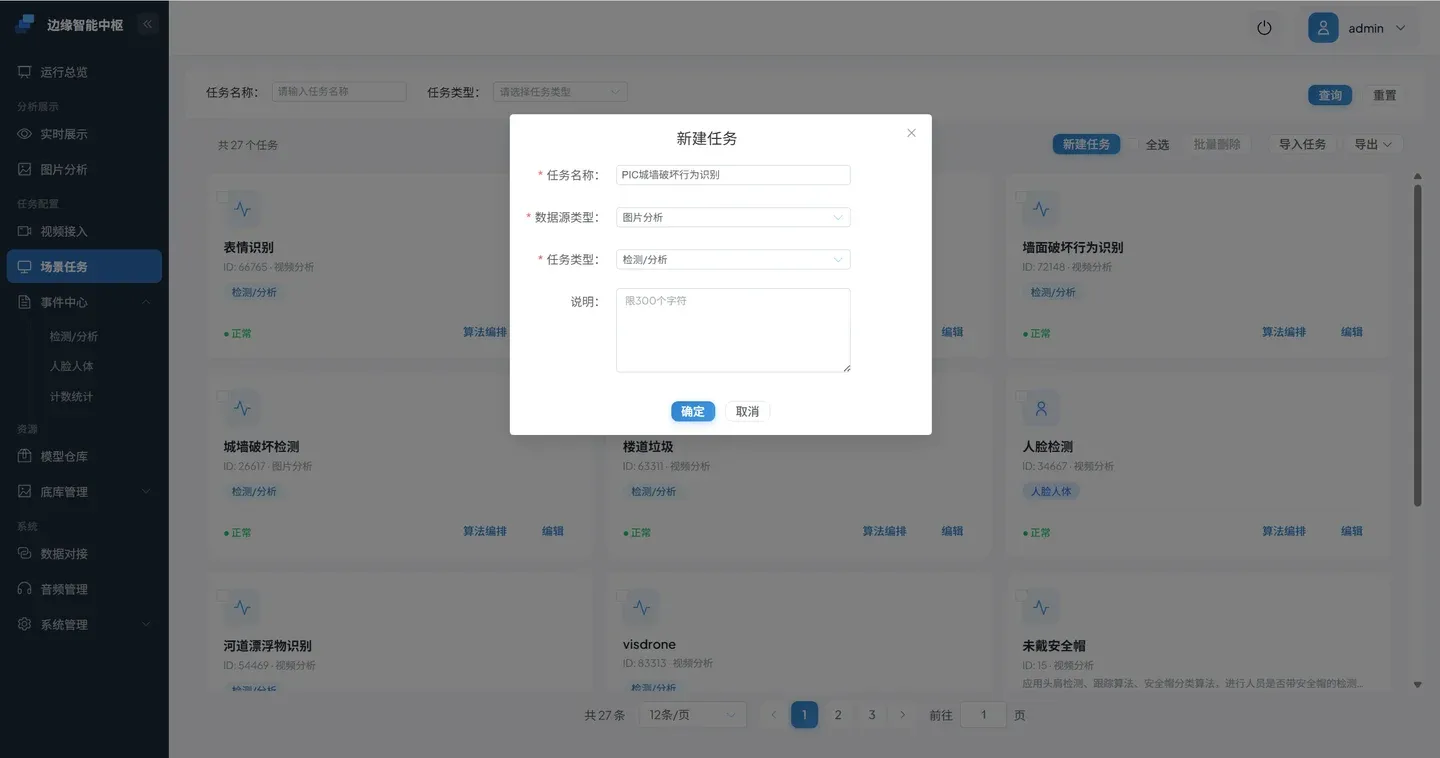
填写任务名称并确认。
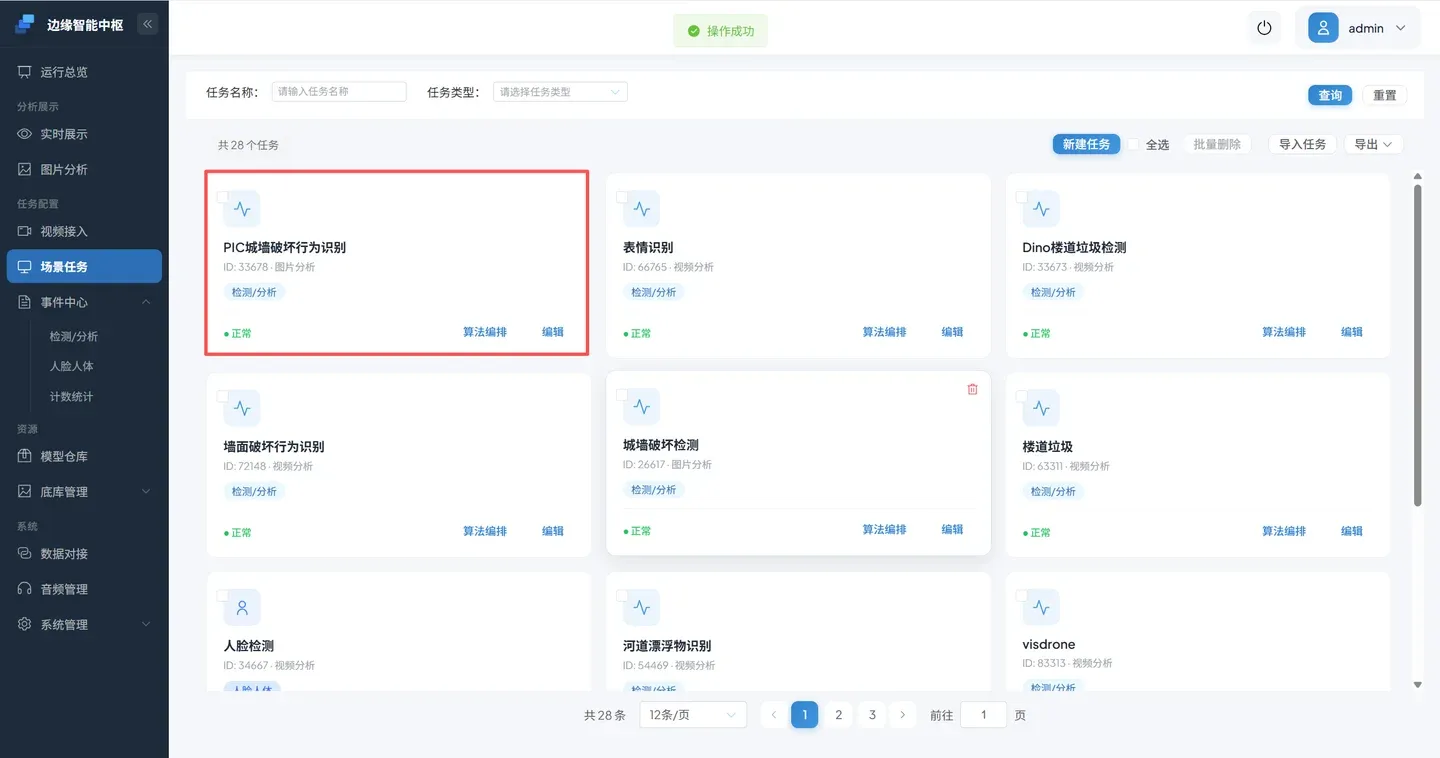
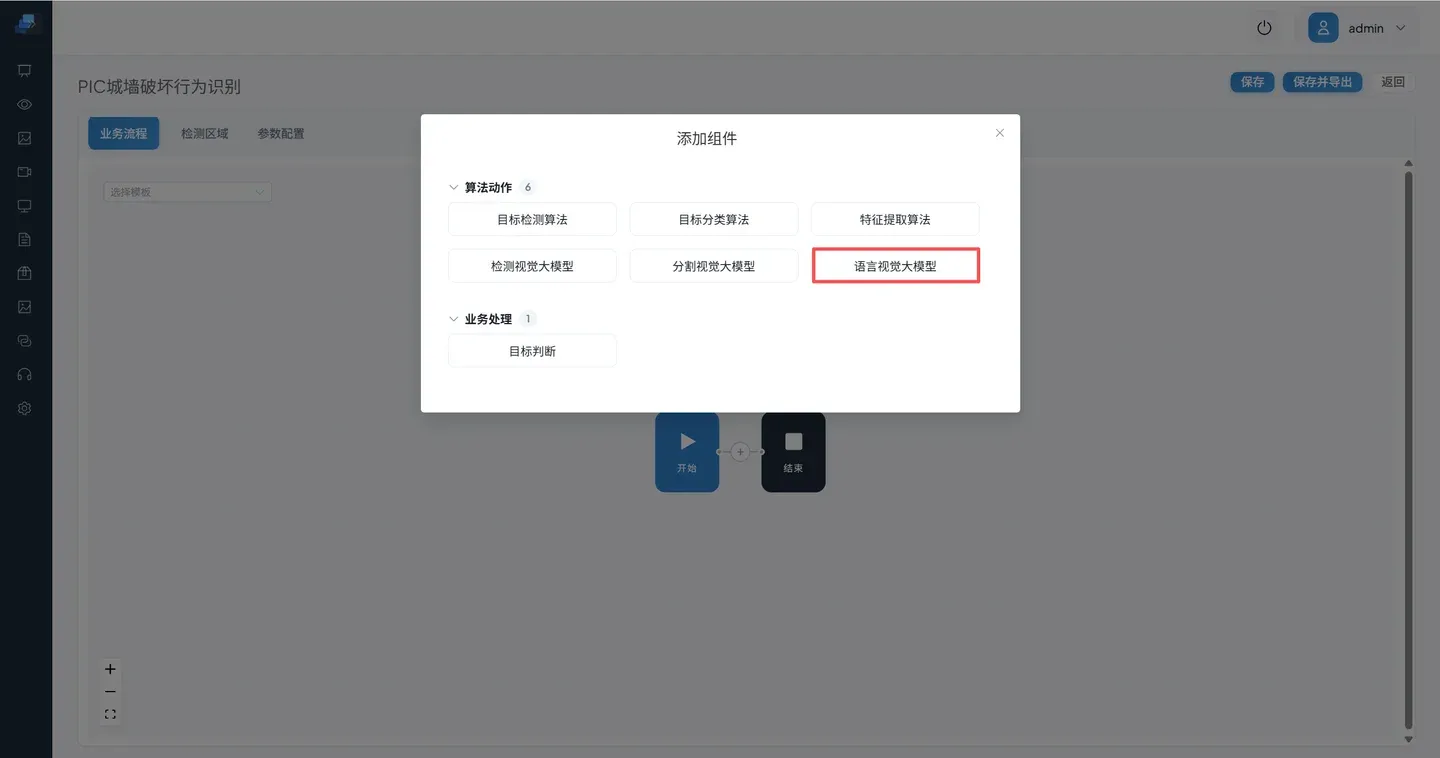
打开 算法编排 → 操作 → 添加组件 → 语言视觉大模型。
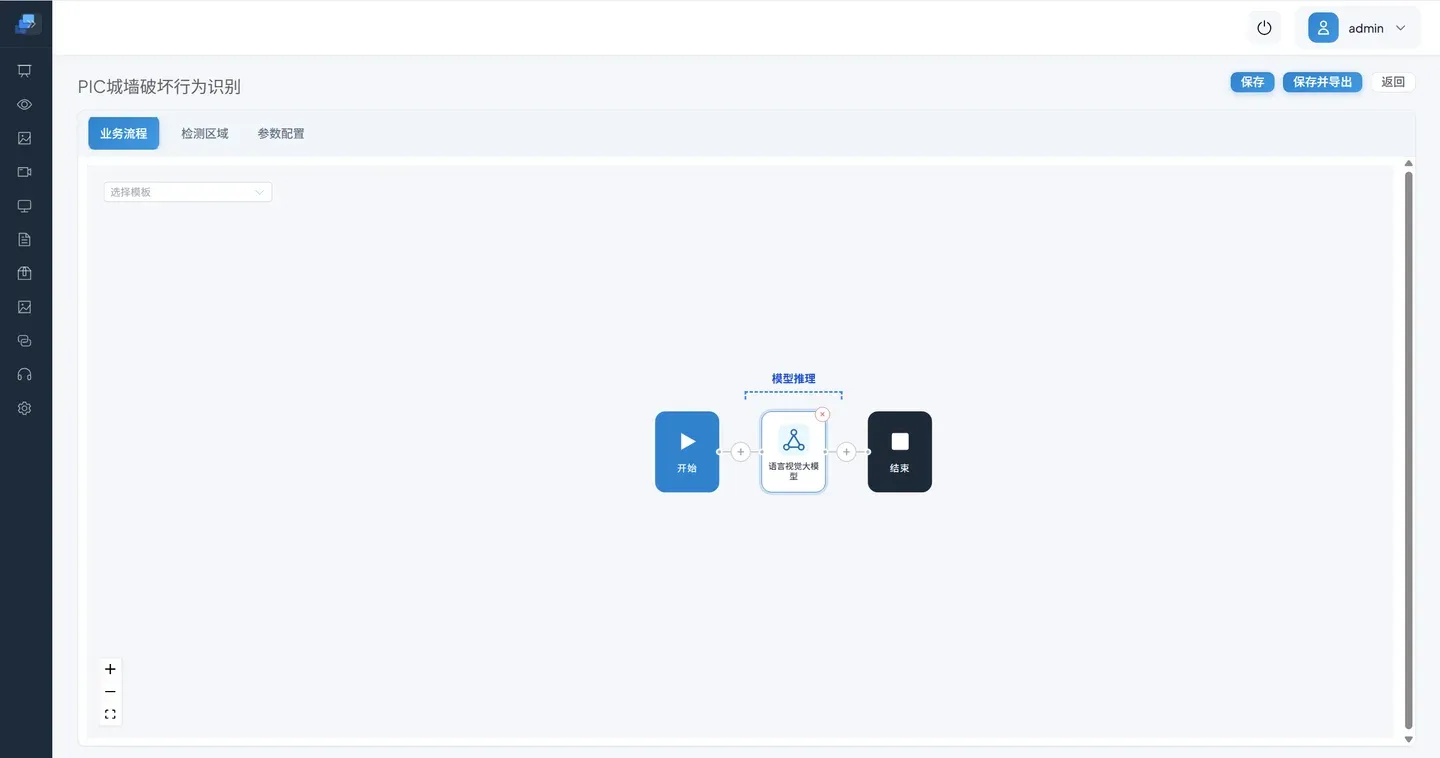
最小图片分析 Pipeline 只需要一个 VLM 节点连接输入与输出。
配置模型,开启高级提示词模式,填写完整问题并保存。
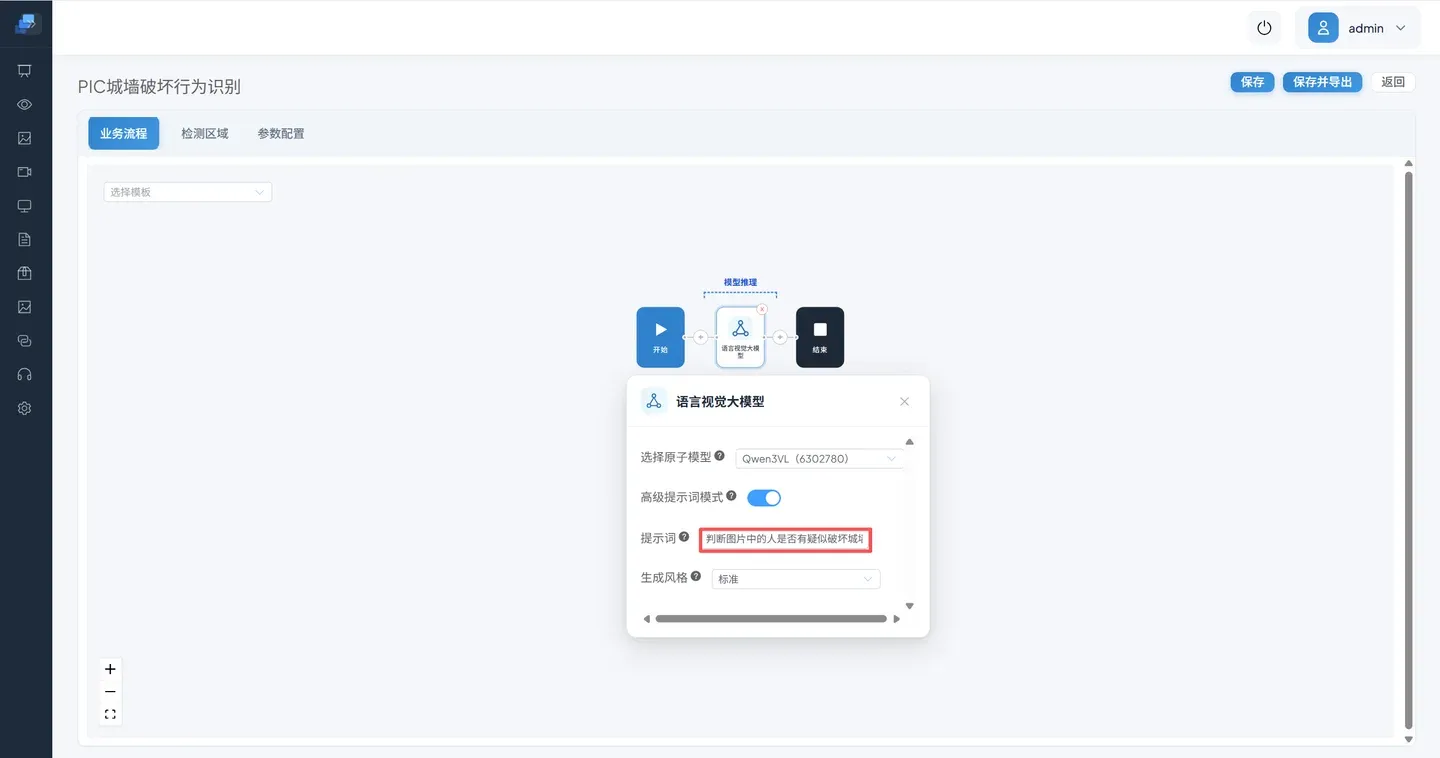
建议第一版:
判断图中的人是否有明显刻画、凿击、喷涂或其他人为破坏墙面的行为,忽略正常参观、触摸、自然风化、阴影和已有旧损伤如果只想判断破坏痕迹而不要求画面中出现人,应改成“判断墙面是否出现新鲜、明显的人为刻画、凿击或喷涂痕迹……”。这两个定义不是同一任务,不能混用样本验收。
3.2 上传固定样本并记录结果
打开 图片分析,选择新建任务。
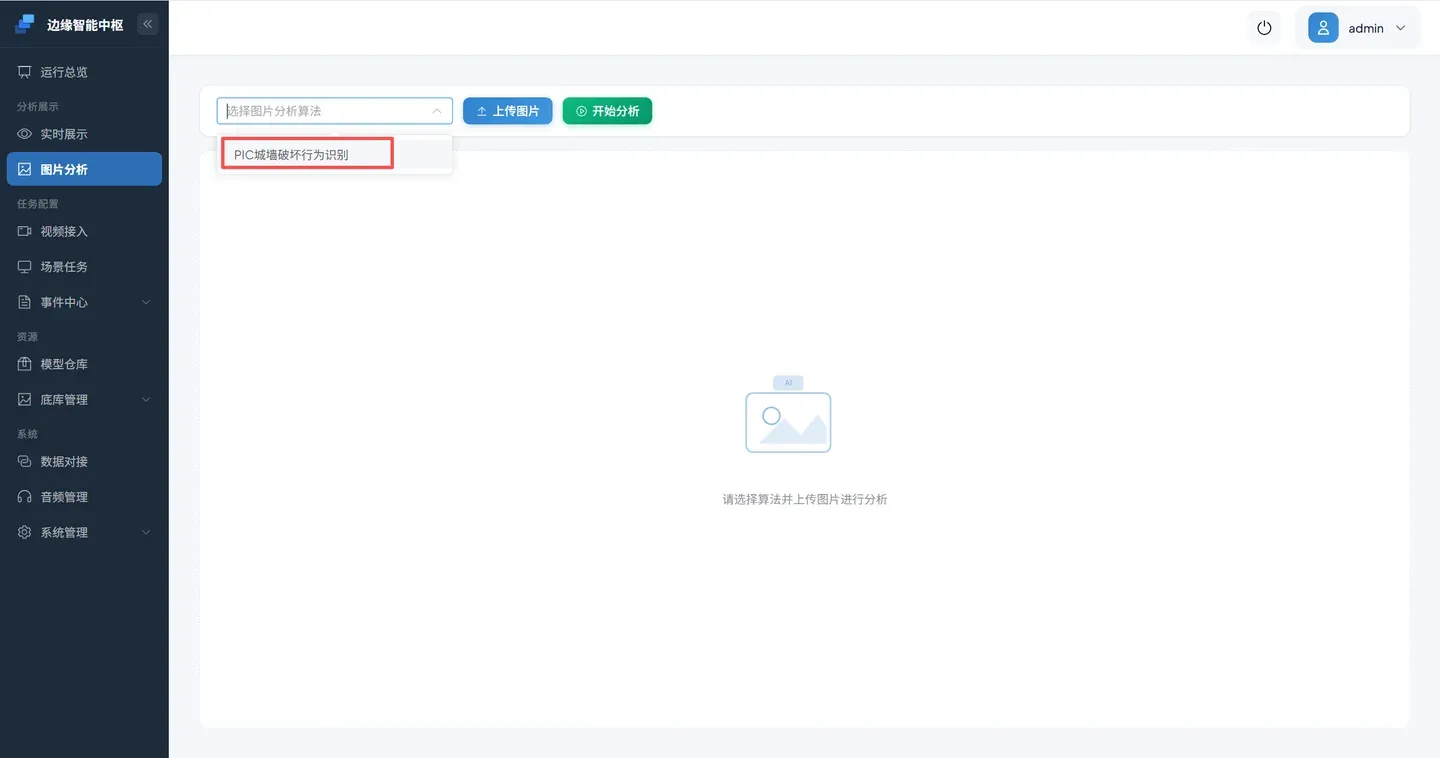
上传一张已标注预期结果的图片。
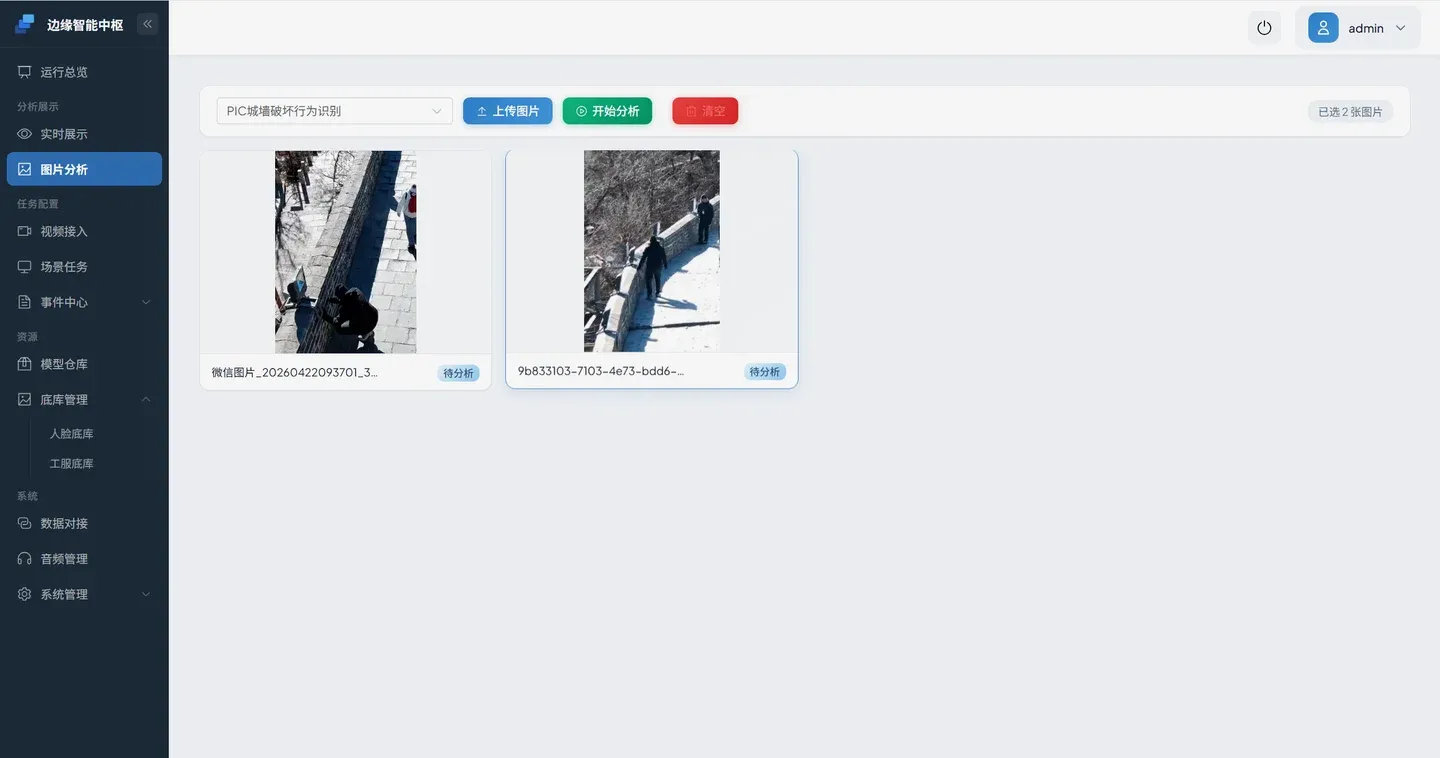
点击 开始分析。首次请求可能触发模型初始化,等待任务明确完成或返回错误。
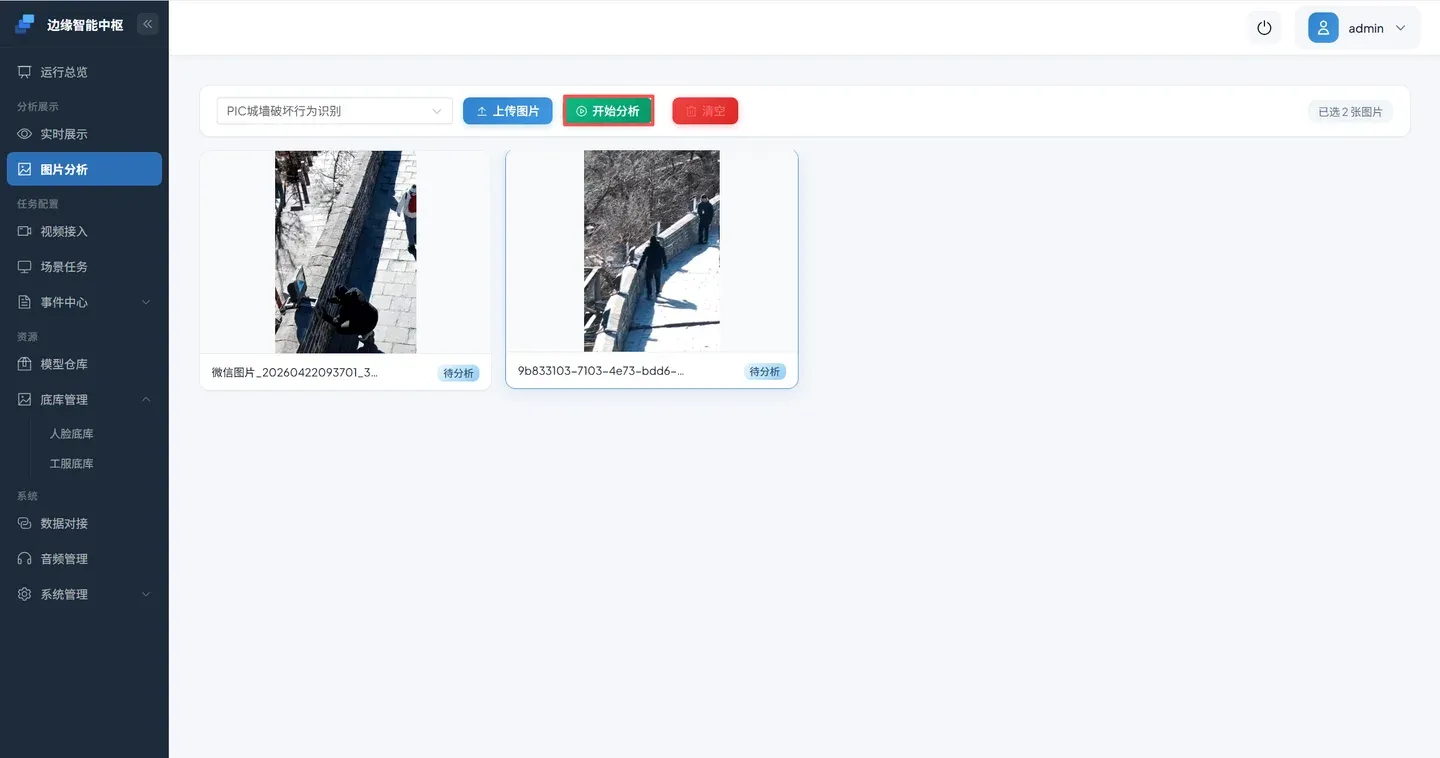
分析完成后,先看“存在/不存在”结果。
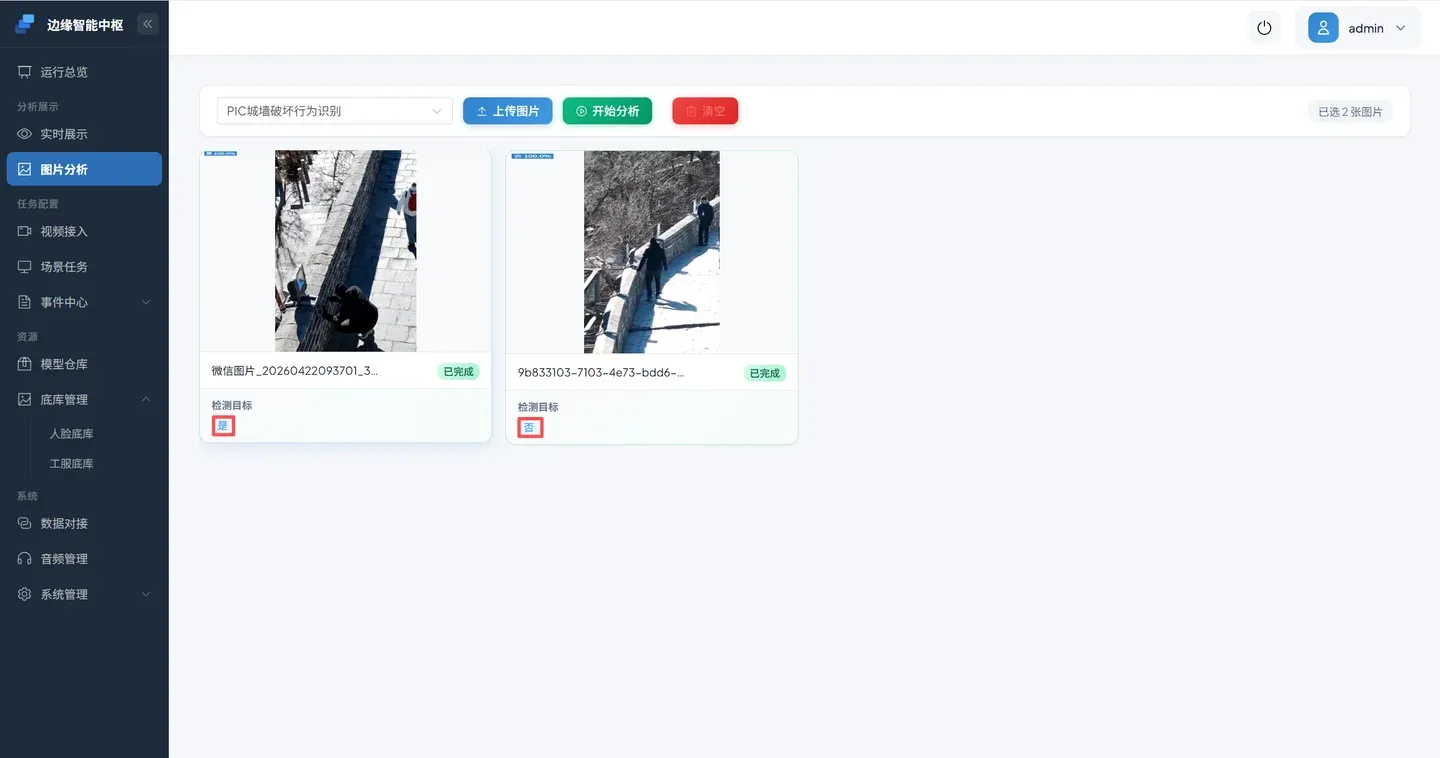
打开命中图片详情,核对逻辑结果和页面提供的置信或附加信息。
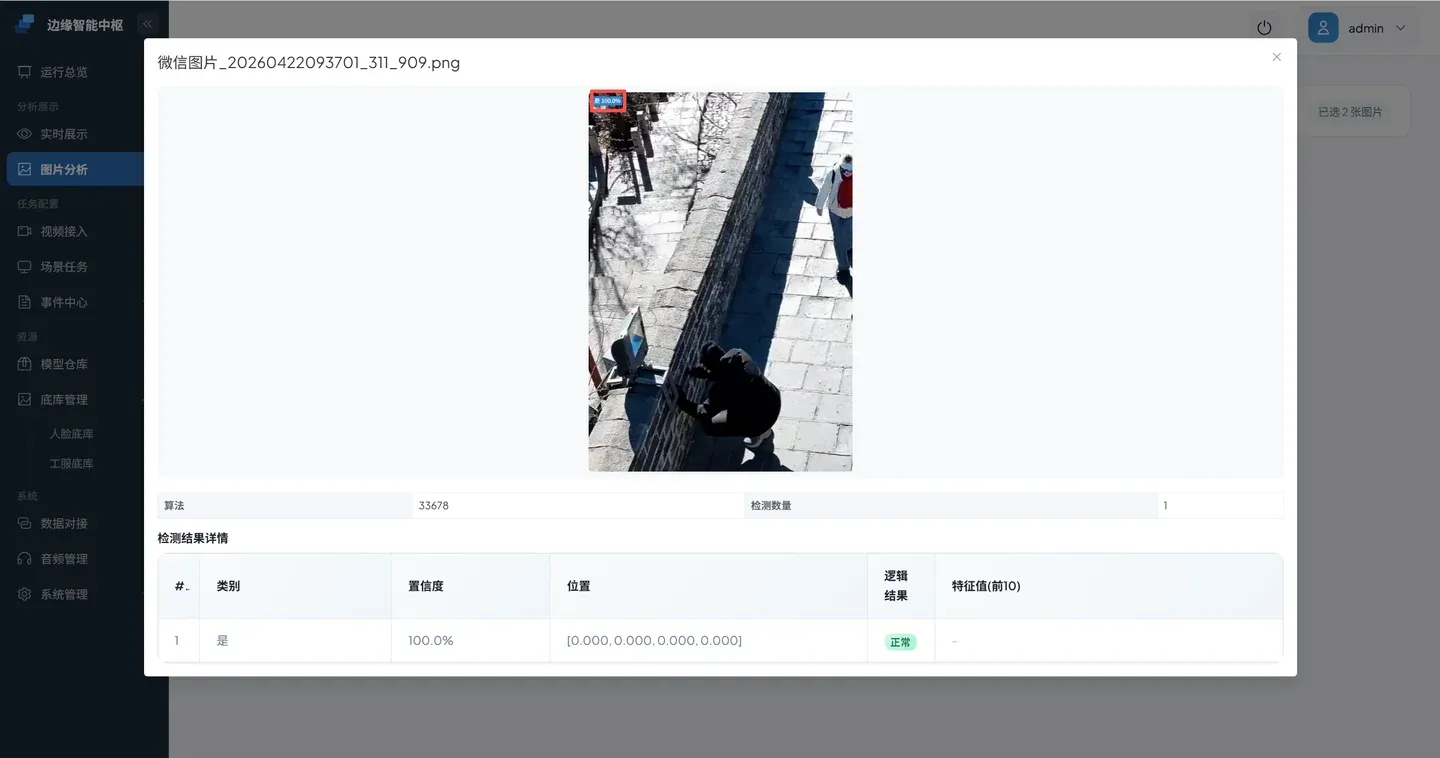
首次基线至少准备:
- 5 张清晰正样本;
- 5 张清晰负样本;
- 现场常见的反光、遮挡、夜间、游客触摸、自然风化和相似纹理等困难样本。
这不是生产精度评估的充分样本量,但足以暴露模型不可用、问题定义错误和明显误判。保存每张图片的预期标签、实际结果、模型、模式、提示词版本和生成参数,修改后对同一批图片复测。
3.3 迭代提示词
漏报时,把“问题”改成可见特征:
不清楚:城墙有没有问题?
更明确:判断城墙表面是否有明显裂缝、缺损、涂鸦、刻画或凿击痕迹,忽略光影
误报时,增加范围和排除项:
范围过宽:判断城墙有没有被破坏
更明确:判断城墙表面是否有明显的人为刻画、凿击或新鲜喷涂痕迹,忽略自然风化、旧修补和阴影
结果不稳定时:
- 固定模型、生成风格和同一批图片。
- 收紧 ROI,减少天空、游客和其他背景。
- 一个提示词只判断一个可见结论。
- 对同一图片重复测试并记录分歧,而不是挑选一次正确结果。
- 再比较“严谨”与“标准”,需要时才调整自定义采样参数。
好问题与坏问题示例:
| 可验收问题 | 不可直接验收的问题 | 原因 |
|---|---|---|
| 楼道地面是否有明显垃圾? | 描述一下楼道情况 | 开放式输出不可直接作为事件规则 |
| 地面是否有可见积水或水洼反光? | 地面湿不湿? | “湿”可能不可见或与材质混淆 |
| 消防器材柜门是否完全关闭? | 消防柜有没有问题? | “有问题”没有视觉边界 |
| 指示灯是否为红色? | 设备有几个指示灯? | 精确计数不是该 VLM 判断链路的强项 |
| 城墙表面是否有人为刻画痕迹? | 城墙坏了吗? | “坏”包含自然风化等多种含义 |
3.4 图片基线通过后接入视频
- 创建或打开视频分析任务,使用同一模型、提示词模式和已验证提示词。
- 设定取帧频率;例如
0.1约为每 10 秒一帧,但是否满足业务发现时延必须由验收决定。 - 分配到城墙监控通道。
- ROI 只覆盖城墙主体。
- 设置事件参数和运行策略,保存并启动。
- 用包含正负片段的视频复测,并观察持续运行资源和错误日志。
4. DINO:创建开放类别检测任务
DINO 的提示词是要定位的目标名称,输出是检测框。它适合“人员和垃圾在哪里”,不直接回答“楼道是否整洁”或“车辆是否违停”等包含业务规则的问题。
4.1 定义目标与参数
当前 DINO 节点使用英文句号分隔多个目标。例如:
person.garbage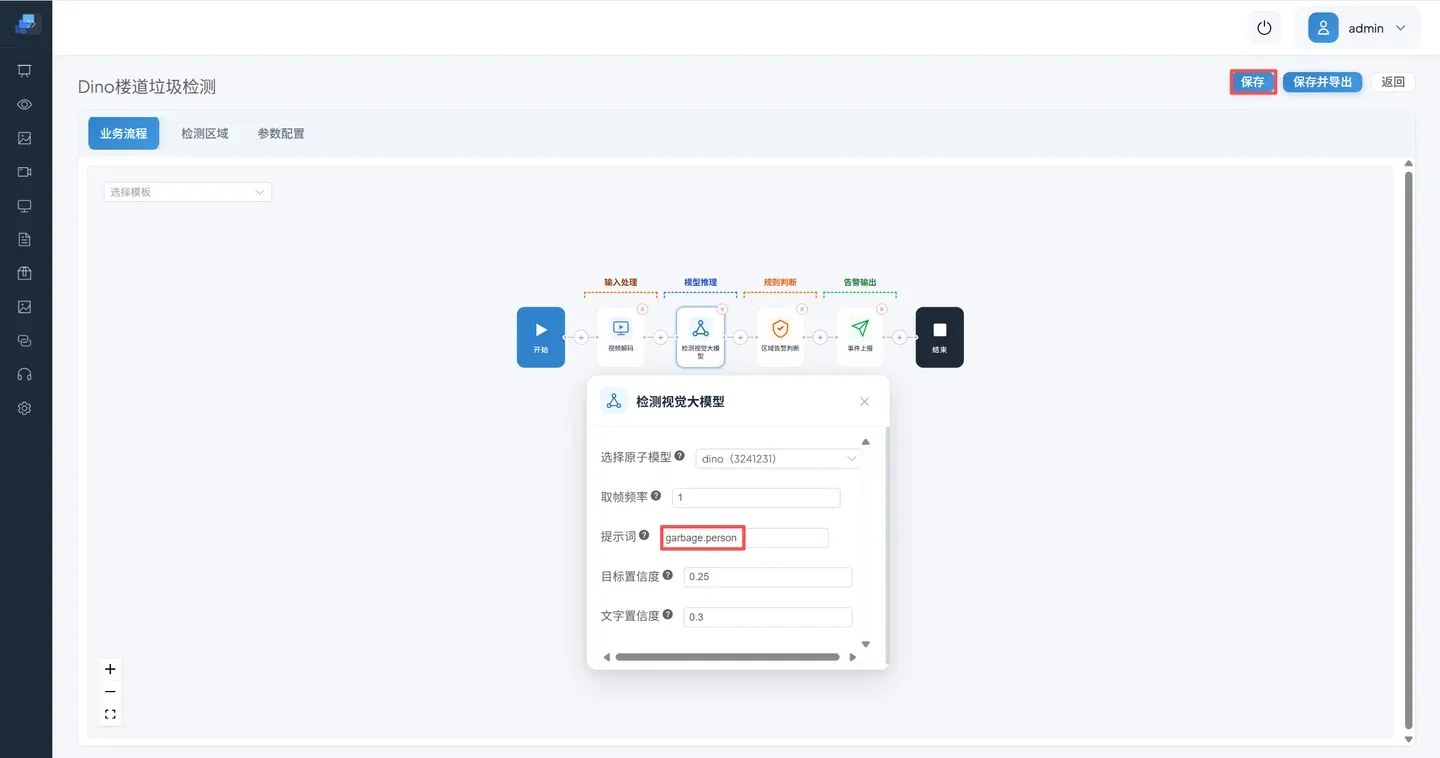
当前节点的基础字段包括:
| 参数 | 当前默认值 | 说明 |
|---|---|---|
| 选择原子模型 | 无 | 必须选择已经安装且与后端匹配的 DINO 模型 |
| 取帧频率 | 1 fps | 不应高于上游帧率;按业务发现时延和资源测量调整 |
| 提示词 | 空 | 使用具体英文名词;多个名称用英文句号分隔 |
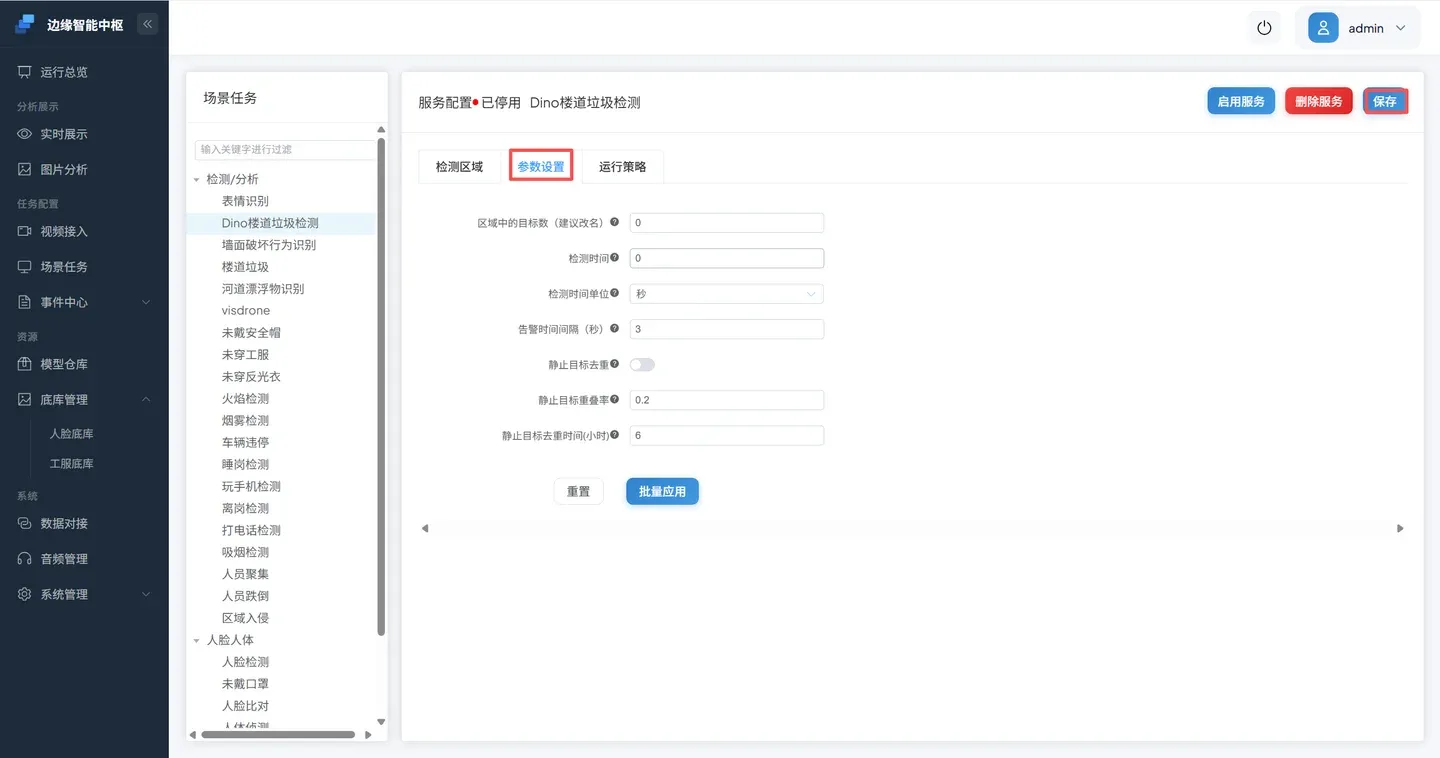
| 目标置信度 | 0.25 | 检测框候选的置信标准 |
| 文字置信度 | 0.3 | 图像目标与文本类别匹配的标准 |
不要同时调低两个阈值。先用单一目标和固定图片确定文本是否匹配,再逐项调整并观察框的数量和位置。
4.2 绑定通道、区域和事件
打开 视频接入,进入目标通道的 场景任务分配。
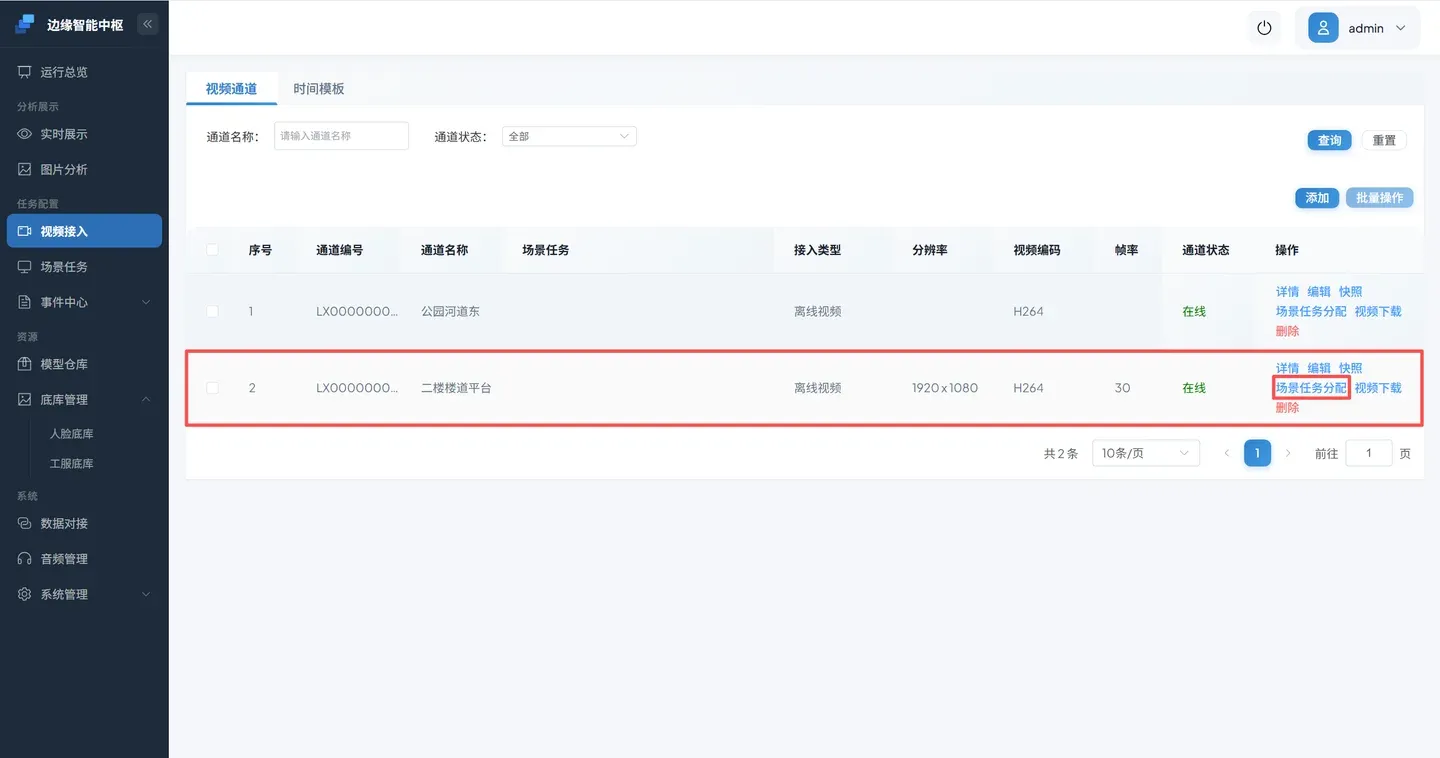
选择使用 检测视觉大模型 的 DINO 任务并新增区域。
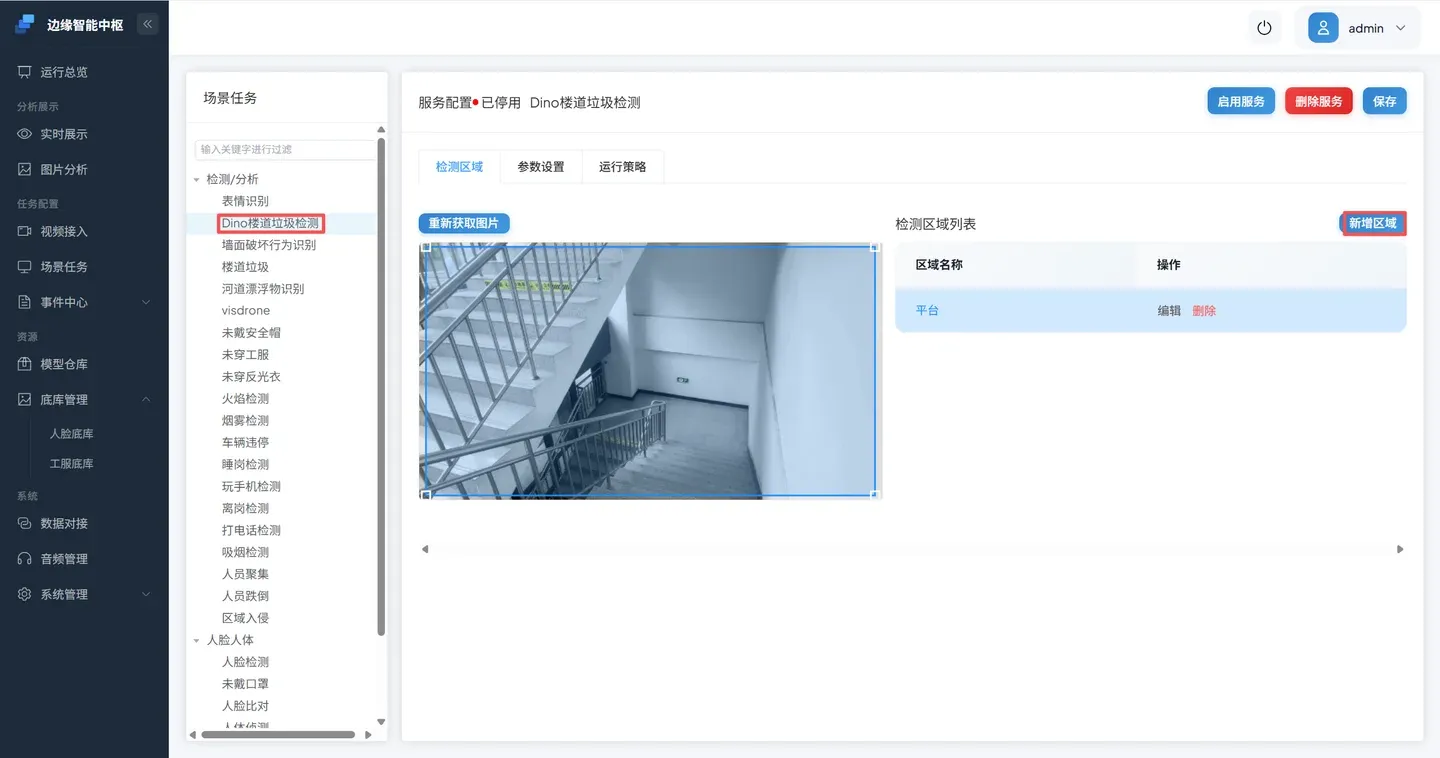
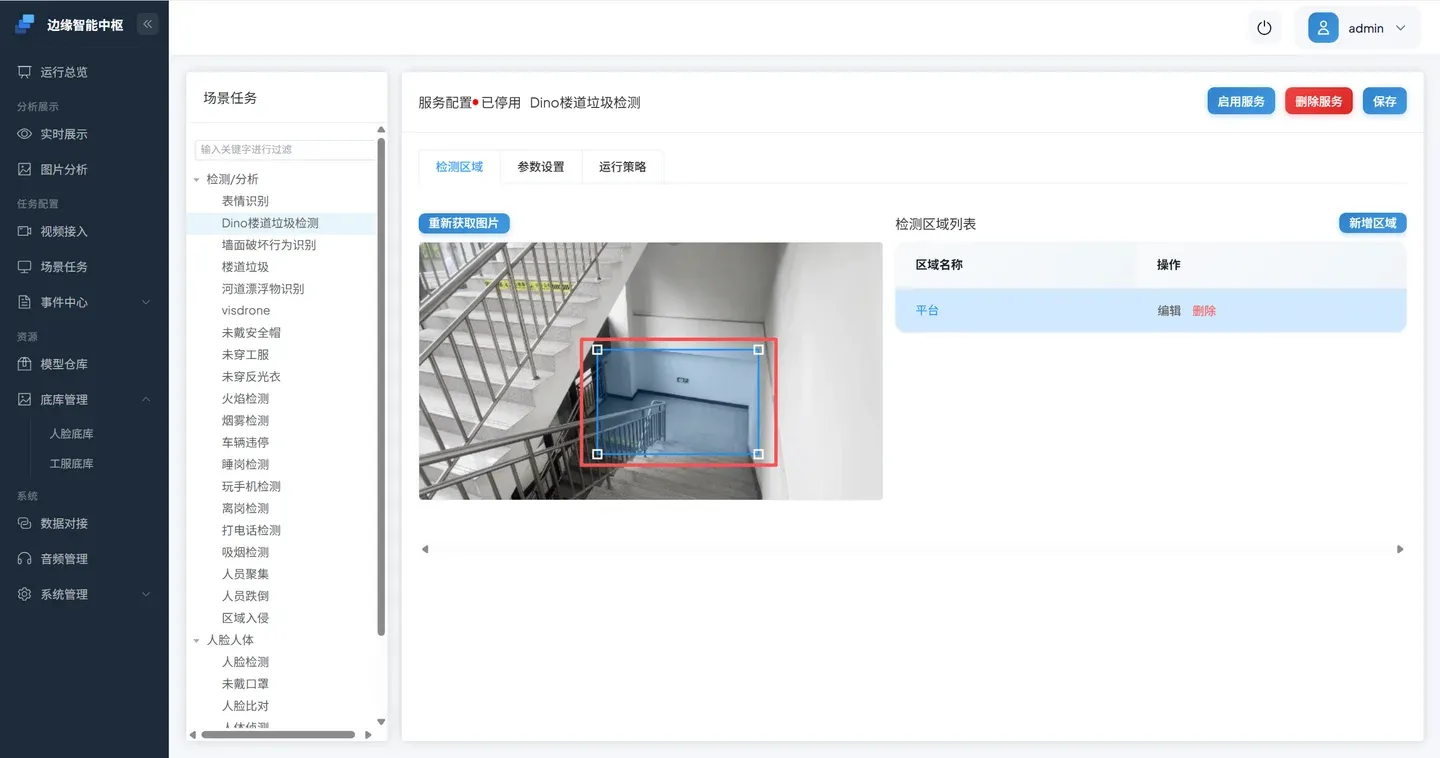
调整区域,只覆盖需要定位人员和垃圾的平台或楼道。
设置事件参数和运行策略,保存并启动。
4.3 查看检测框和事件
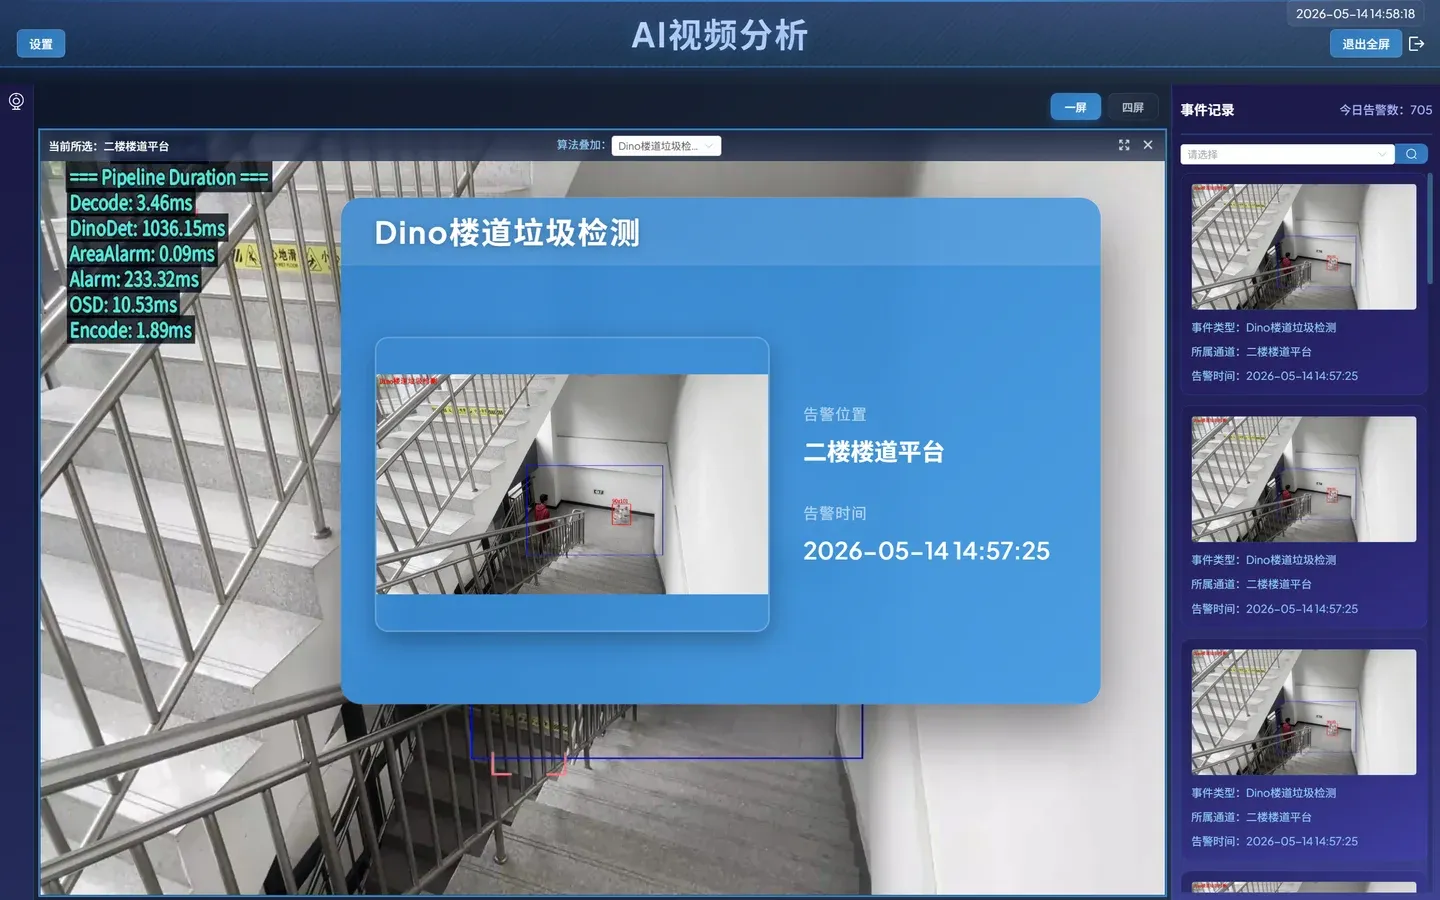
打开 实时展示,选择通道和 DINO 叠加层。
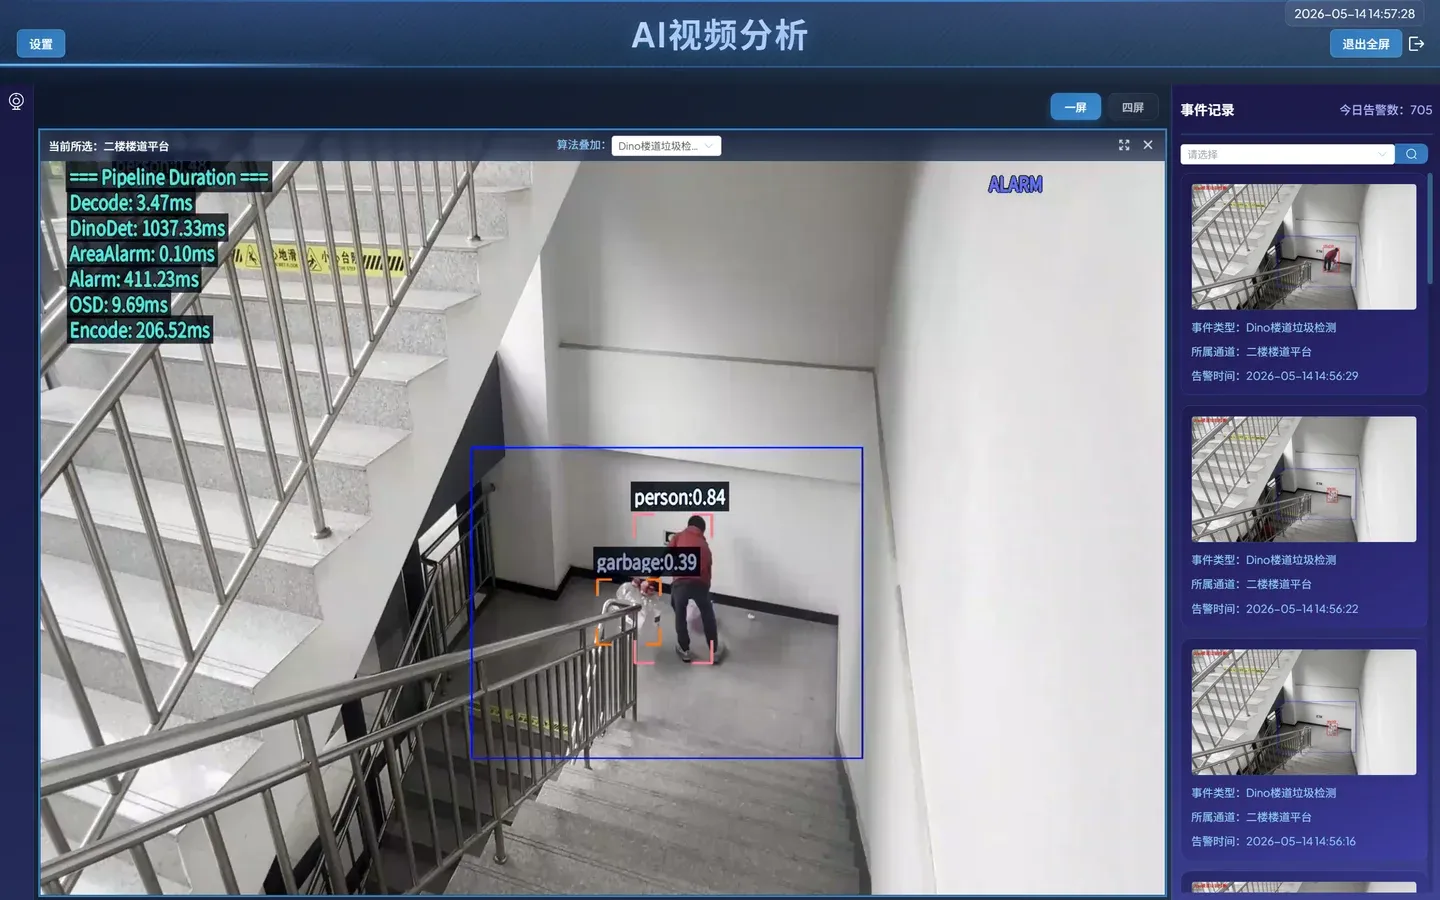
检测框可能晚于原始视频更新,尤其在低取帧频率或高推理负载下。以带时间信息的抓拍和事件核对,不凭一次视觉印象判断同步性。
打开 事件中心,按通道和任务查询上报记录。
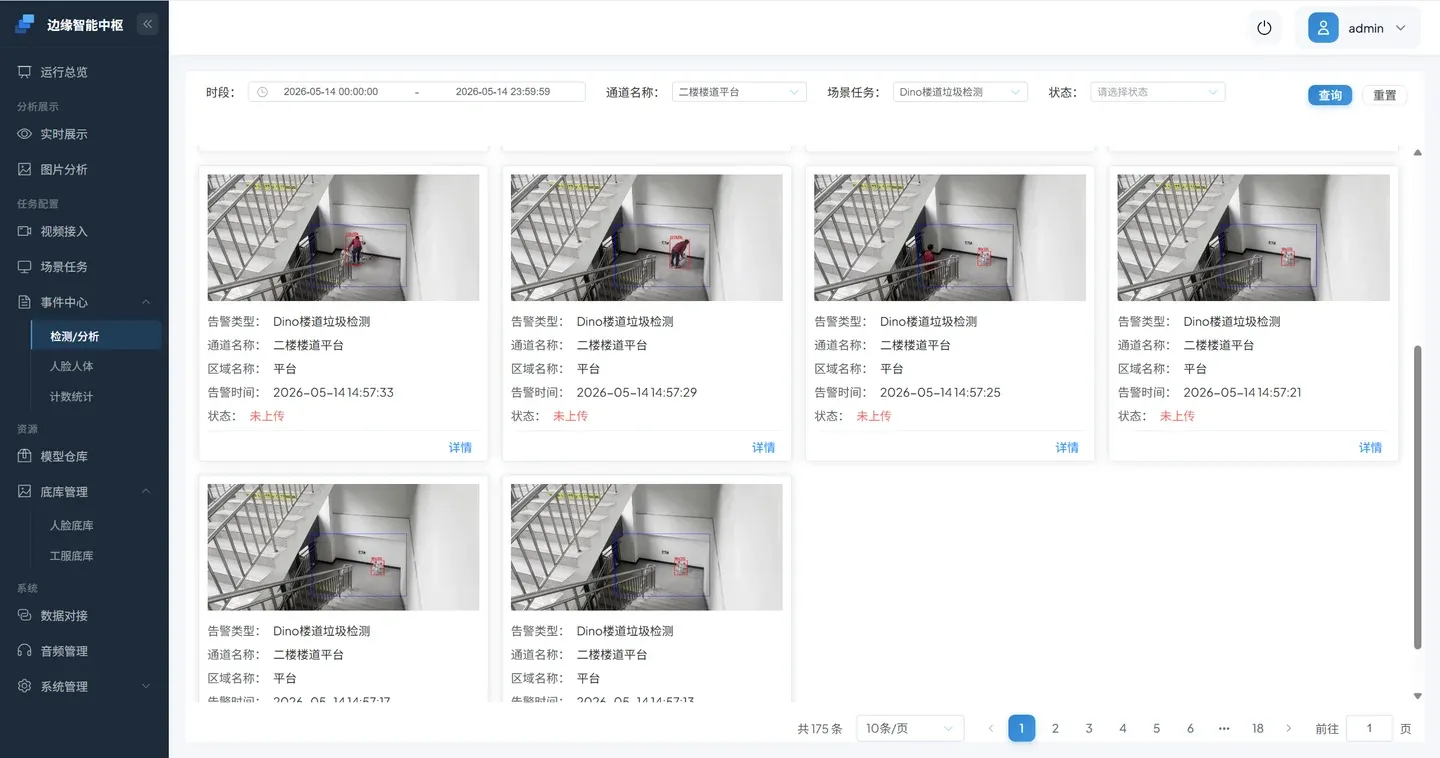
期望结果:人员标为 person,肉眼可辨识的垃圾标为 garbage,背景没有大量同类框,目标进入区域并满足事件条件后有对应记录。如果多词不稳定,先分别测试 person 和 garbage。
4.4 DINO 目标词速查
| 中文目标 | 首选英文词 | 验证提醒 |
|---|---|---|
| 人员 | person | 与人形海报和屏幕画面做负样本 |
| 车辆 | car 或 vehicle | vehicle 范围更广,两者分别测试 |
| 垃圾 | garbage 或 trash | 不要把“区域脏乱”直接作为目标词 |
| 灭火器 | fire extinguisher | 远距离小目标需单独验证 |
| 猫 / 狗 | cat / dog | 遮挡、夜间和小目标需困难样本 |
| 箱子 / 包裹 | box / package | 分别测试,避免一次堆叠近义词 |
| 椅子 | chair | 密集摆放时检查重复框 |
| 烟雾 | smoke | 与云雾、蒸汽、曝光异常做负样本 |
| 火焰 | fire 或 flame | 与灯光、反光、屏幕画面做负样本 |
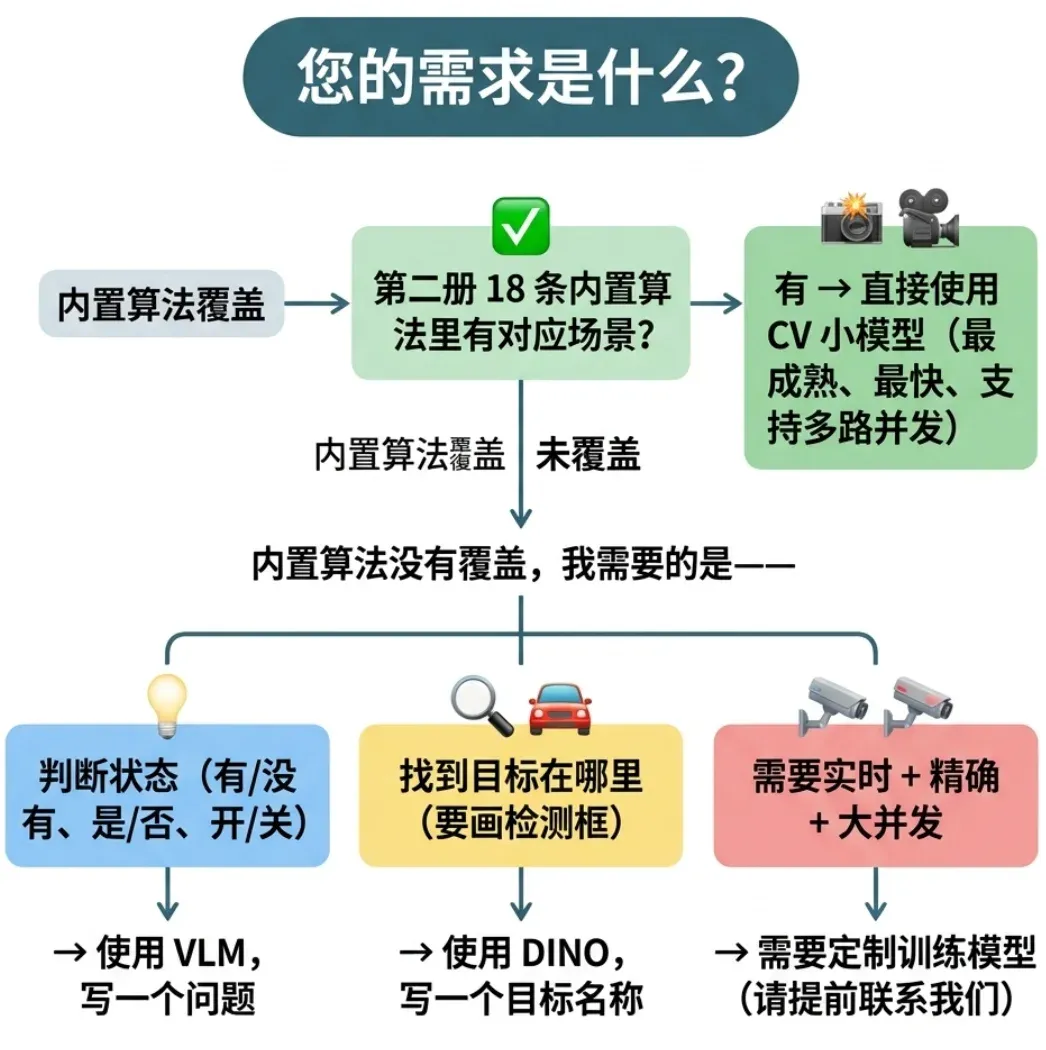
5. CV、VLM 与 DINO 的选择路径
- 当前内置场景已有对应任务且结果满足要求:使用传统模型。
- 没有对应任务,需要判断一个单帧可见状态:用图片先验证 VLM。
- 需要开放类别检测框:用图片或单路视频先验证 DINO。
- 需要高频、确定性、精确计数、多路并发或安全关键闭环:在目标硬件上做量化比较,必要时使用专用模型和规则 Pipeline。
| 对比项 | 传统检测/分类 | VLM | DINO |
|---|---|---|---|
| 规则来源 | 固定模型类别与 Pipeline | 一段目标短语或完整问题 | 一个或多个目标名词 |
| 主要输出 | 框、类别、分数和规则结果 | 是/否判断与事件 | 框、类别和分数 |
| 场景切换 | 更换模型、标签或规则 | 修改提示词并重新验证 | 修改目标词并重新验证 |
| 最适合 | 高频固定类别和成熟业务 | 长尾可见状态判断 | 长尾目标定位 |
| 画面表现 | 通常有检测框或业务叠加 | 通常无检测框 | 有检测框,但更新取决于抽帧和推理 |
| 上线证据 | 标注集指标、性能和业务规则验收 | 固定正负/困难样本、稳定性、事件和资源 | 框的位置与类别、误检漏检、事件和资源 |
三者互补,不是按“新技术一定替代旧模型”排序。
6. 提示词模板与验证记录
6.1 VLM 参考模板
以下完整问题都要求开启 高级提示词模式:
| 场景 | 参考提示词 | 预期输出 | ROI 建议 |
|---|---|---|---|
| 垃圾桶满溢 | 判断垃圾桶内垃圾是否已达到桶口或明显溢出,忽略桶外正常摆放物品 | 是 / 否 | 只覆盖垃圾桶和桶口 |
| 消防柜门状态 | 判断消防器材柜门是否完全关闭,忽略玻璃反光 | 是 / 否 | 覆盖柜门边缘和锁扣 |
| 门禁状态 | 判断门扇是否处于明显开启状态 | 是 / 否 | 覆盖门扇与门框 |
| 指示灯 | 判断设备指示灯是否为红色 | 是 / 否 | 紧贴指示灯区域 |
| 通道堵塞 | 判断消防通道地面是否被箱子、车辆或成堆杂物明显堵塞,忽略行人短暂经过 | 是 / 否 | 覆盖通道地面 |
| 工位状态 | 判断该工位座位或操作位置是否有人值守 | 是 / 否 | 覆盖座位与操作区域 |
如果希望普通模式自动包装,只填写目标短语,例如 消防柜门打开,不要把上表完整句子填入普通模式。
6.2 每个任务的验证记录
| 项目 | 要记录的内容 |
|---|---|
| 任务定义 | 一句话说明什么条件应该触发 |
| 提示词版本 | 模式、完整文本和修改时间 |
| 输入样本 | 正样本、负样本和困难样本的固定集合 |
| 运行条件 | 模型、设备后端或远程服务、ROI、取帧频率、生成风格和阈值 |
| 实际结果 | 每张图或每段视频的判断、检测框和事件 |
| 接受标准 | 可接受的漏报、误报、时延、费用和资源占用 |
新任务至少确认:
- [ ] 图片分析已覆盖至少 5 张清晰正样本和 5 张清晰负样本。
- [ ] 已加入现场常见困难样本,而不是只测试理想图片。
- [ ] 使用相同配置对同一批图片复测,结果差异已记录。
- [ ] ROI 排除了无关背景。
- [ ] 取帧频率与允许发现时延一致,并经过资源测量。
- [ ] 视频正负片段、事件抓拍和持续运行均通过。
7. 常见问题
VLM 没有结果
- 确认原子模型和分词器已经安装,而不是只有任务模板。
- 本地模型确认运行在支持的 Sophon 后端;远程服务确认网络、地址、模型名、端点和凭据有效。
- 先用单张清晰图片测试,排除视频抽帧与 ROI。
- 查看模型初始化、内存不足、请求超时和响应解析日志。
- 图片模式通过后再恢复视频任务。
VLM 完整提示词结果异常
检查 高级提示词模式。如果关闭,系统会把完整句子再次包装为“是否存在【完整句子】目标”;开启后才会按完整问题执行。修正模式后必须对原固定样本全部复测。
VLM 结果不稳定
- 固定模型、模式、生成风格和样本。
- 将模糊问题拆成一个可见、单一的判断。
- 加入关键视觉特征和明确排除项。
- 收紧 ROI。
- 使用严谨风格或在受控记录下减少采样随机性。
- 相同输入仍无法达到标准时,改用专用模型或人工复核。
远程 VLM 超时或偶发失败
检查 CosmoEdge 到远程地址的 DNS、路由、TLS 和代理,比较服务端日志与 timeout_ms,并确认服务模型名和 /chat/completions 兼容性。降低取帧频率避免请求堆积。不要通过无限增大超时掩盖服务不可用。
DINO 没有框或框太多
- 确认目标足够大且肉眼可辨。
- 每次只测试一个具体英文名词。
- 同义词分别记录,不要一次堆叠多个近义词。
- 检查 ROI、目标置信度、文字置信度和模型资源。
- 固定高频类别应比较传统检测模型的稳定性和成本。
目标定义本身含糊
让业务方先独立标注一组“应该触发”和“不应该触发”的图片。如果人员之间无法达成一致,提示词或模型也无法形成稳定验收标准。先定义业务边界,再选择技术。
完成验收
- [ ] 已说明为什么选择 VLM、DINO 或传统模型。
- [ ] VLM 普通模式只使用目标短语,完整问题已开启高级提示词模式。
- [ ] 本地或远程推理配置已记录,密钥没有进入文档和版本库。
- [ ] VLM 使用固定正负和困难样本完成图片验证。
- [ ] DINO 在预期目标位置输出类别和检测框。
- [ ] 视频任务的区域、频率、参数和运行策略已记录。
- [ ] 事件中心结果与任务定义一致。
- [ ] 已完成持续运行观察,没有未解释的模型、网络或资源错误。
下一步
阅读算法编排,把输入、模型、规则和输出组织成可维护的 Pipeline。